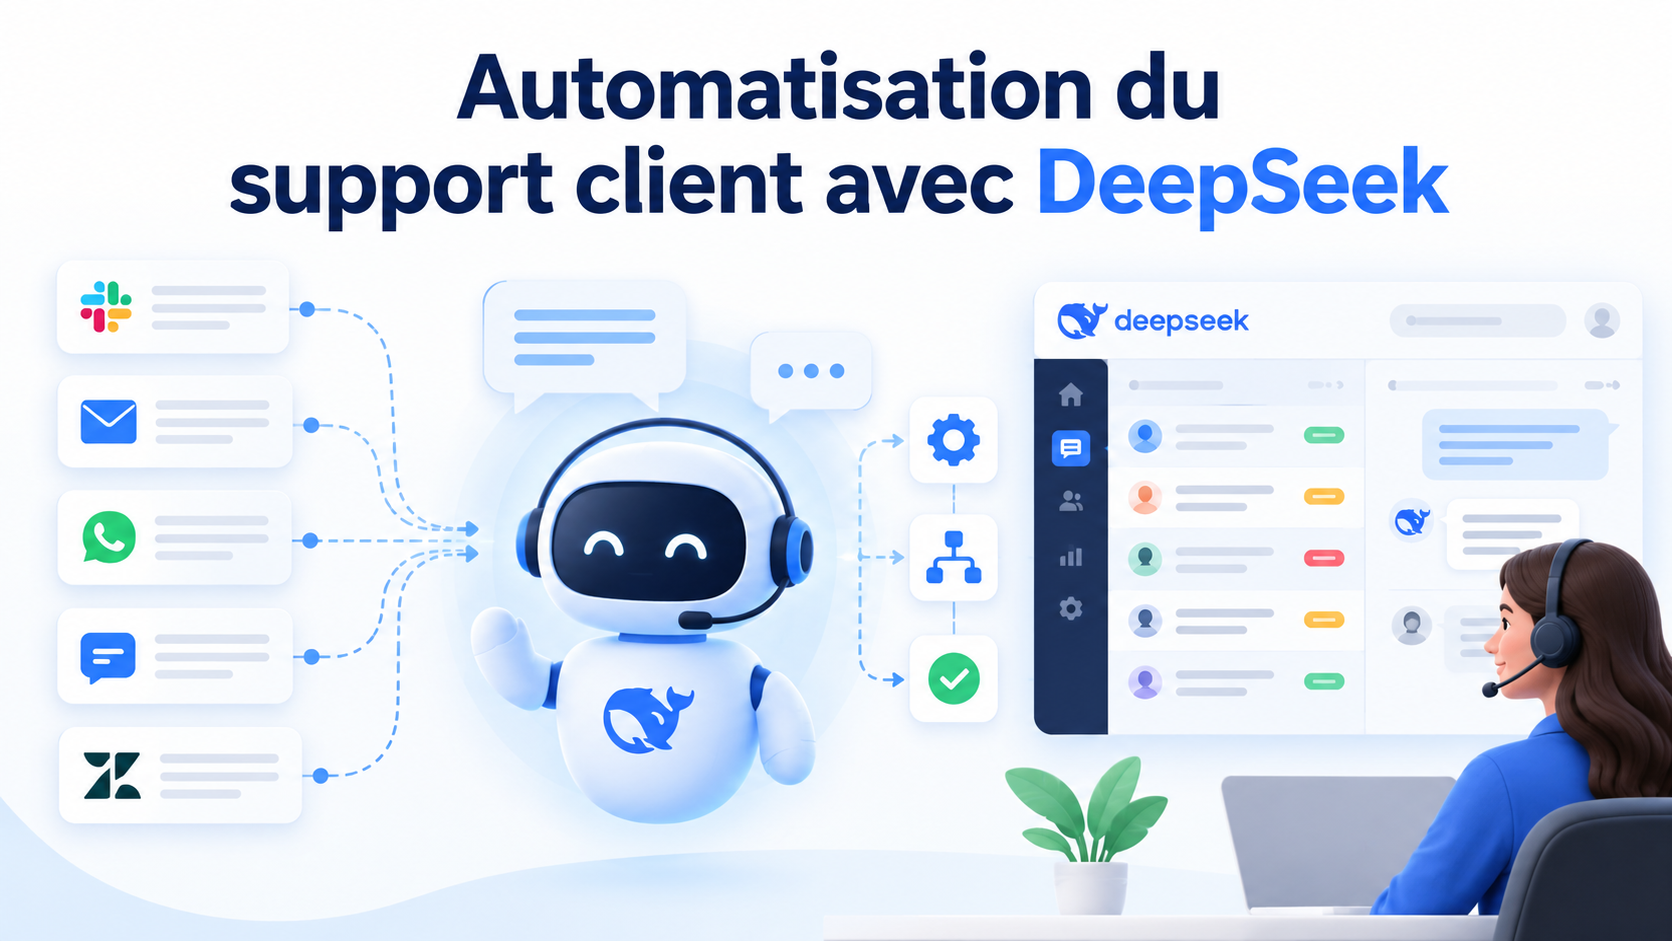

L’automatisation du support client avec DeepSeek est possible pour classer les tickets, retrouver une information dans une base de connaissances, préparer des réponses, résumer des échanges ou déclencher des actions métier contrôlées. DeepSeek ne constitue toutefois pas, à lui seul, un logiciel de service client complet.
Une solution opérationnelle nécessite généralement un canal de conversation, un helpdesk ou un CRM, un service d’orchestration, une base de connaissances, des règles d’autorisation, un système de suivi et un processus d’escalade vers un conseiller humain. Le modèle produit ou structure les réponses ; l’application reste responsable de l’identité du client, des données transmises et des actions réellement exécutées.
La stratégie la plus prudente consiste à commencer par un usage d’assistance aux agents, puis à automatiser progressivement les demandes simples dont les réponses peuvent être vérifiées. Ce guide présente une architecture concrète, un exemple d’intégration à l’API DeepSeek, les contrôles indispensables et une méthode de déploiement adaptée aux entreprises françaises.
Que peut automatiser DeepSeek dans un service client ?
DeepSeek peut intervenir à plusieurs étapes du traitement d’une demande, avant, pendant ou après la conversation avec le client. France Num cite notamment les réponses aux questions fréquentes, la qualification des demandes et l’orientation des clients parmi les usages prioritaires de l’intelligence artificielle dans le support.
Les tâches les plus adaptées sont celles qui sont répétitives, documentées, réversibles et faciles à vérifier.
| Tâche | Utilisation possible de DeepSeek | Niveau de contrôle recommandé |
|---|---|---|
| Questions fréquentes | Rechercher la réponse dans un centre d’aide et rédiger une réponse sourcée | Automatisation limitée si la documentation est fiable |
| Classification des tickets | Identifier la catégorie, la langue, la priorité et l’équipe destinataire | Contrôle statistique régulier sur des tickets réels |
| Résumé d’une conversation | Produire une synthèse des faits, actions tentées et points restant à résoudre | Validation rapide par le conseiller |
| Rédaction de réponses | Préparer un brouillon conforme au ton et aux règles de l’entreprise | Approbation humaine au début du projet |
| Recherche d’une commande | Proposer l’appel d’une fonction de consultation en lecture seule | Authentification et autorisation obligatoires |
| Création d’un ticket | Structurer les données puis demander au backend de créer le ticket | Validation des champs et journalisation |
| Remboursement ou annulation | Collecter les informations et préparer une recommandation | Décision humaine ou règles métier strictement contrôlées |
Les demandes liées à un paiement, une fraude, une identité, une fermeture de compte, un litige, une donnée de santé ou un engagement contractuel ne devraient pas être confiées à un modèle sans contrôles supplémentaires. Une réponse fluide ne prouve ni sa justesse ni son respect de la politique commerciale.
DeepSeek n’est pas une plateforme Helpdesk complète
L’API DeepSeek fournit un accès à des modèles capables d’analyser du texte, de générer des réponses structurées et de proposer des appels d’outils. Elle ne fournit pas automatiquement toutes les fonctions nécessaires à un service client.
Une mise en œuvre complète peut nécessiter :
- Un widget de discussion, une boîte e-mail, WhatsApp Business ou un autre canal client.
- Un helpdesk comme Zendesk, Freshdesk ou Intercom, ou un système de tickets développé en interne.
- Un backend chargé de communiquer avec DeepSeek et les applications métier.
- Un mécanisme d’authentification pour identifier le client.
- Une base de connaissances approuvée et régulièrement mise à jour.
- Une couche de recherche ou de RAG pour retrouver les informations utiles.
- Des règles d’autorisation distinctes pour chaque outil et chaque type de client.
- Une gestion de l’historique des conversations.
- Des journaux techniques, des alertes et des indicateurs de qualité.
- Une interface permettant à un conseiller de reprendre la conversation.
Acheter des crédits API ne crée donc pas immédiatement un chatbot de support. L’API représente seulement une composante de l’architecture finale.
Quel niveau d’automatisation choisir ?
Une entreprise n’est pas obligée de passer directement à un agent autonome. Il est plus efficace de choisir un niveau correspondant à la qualité de ses données, à la maturité de son équipe et au risque associé aux demandes.
| Niveau | Fonctionnement | Exemple |
|---|---|---|
| Assistance aux conseillers | DeepSeek prépare un résultat que l’agent vérifie systématiquement | Résumé du ticket et brouillon de réponse |
| Automatisation contrôlée | Le système classe, recherche et prépare une action soumise à approbation | Orientation du ticket et proposition d’article d’aide |
| Résolution autonome limitée | Les demandes simples sont traitées automatiquement si les règles sont satisfaites | Horaires, procédure documentée ou suivi générique |
| Workflow agentique | Le modèle peut demander l’utilisation d’outils autorisés dans un parcours à plusieurs étapes | Vérifier une commande, créer un ticket puis résumer la réponse |
Cette classification constitue un cadre pratique, pas une norme universelle. Pour la majorité des entreprises, le meilleur point de départ est le premier ou le deuxième niveau. Les corrections des agents fournissent ensuite des données utiles pour déterminer les demandes qui peuvent être automatisées sans dégrader le service.
Architecture recommandée pour un support client DeepSeek
Une architecture robuste sépare la conversation, la génération de texte et l’exécution des actions métier. Le flux peut être représenté ainsi :
Canal client
→ Helpdesk ou webhook
→ Authentification et règles métier
→ Recherche dans la base de connaissances
→ API DeepSeek
→ Validation de la réponse ou des outils demandés
→ Réponse au client ou transfert vers un conseiller
→ Journalisation et mesure de la qualité
1. Le canal reçoit la demande
La demande peut provenir d’un formulaire, d’un e-mail, d’un widget Web, d’une application mobile ou d’une plateforme de messagerie. Le canal doit transmettre au backend uniquement les informations nécessaires au traitement.
2. Le backend identifie le contexte autorisé
Le backend vérifie l’identité du client lorsqu’une donnée de compte est nécessaire. Le modèle ne doit jamais déterminer l’identité d’une personne à partir de ce qu’elle affirme dans le message.
Une phrase telle que « je suis le titulaire de la commande 12345 » ne constitue pas une authentification. L’accès à la commande doit provenir d’une session authentifiée ou d’un mécanisme de vérification séparé.
3. Le système recherche les informations pertinentes
Pour une question concernant une politique de retour, une procédure technique ou une option d’abonnement, l’application retrouve d’abord les passages utiles dans la documentation approuvée. Elle les transmet ensuite à DeepSeek avec la question du client.
4. DeepSeek prépare une réponse ou propose un outil
Le modèle peut rédiger une réponse fondée sur les sources reçues ou demander l’appel d’une fonction, par exemple get_order_status. Il ne consulte pas directement la base de commandes : l’application doit valider et exécuter la fonction.
5. Une règle décide entre réponse et escalade
Le système vérifie la présence d’une source, les autorisations, le type de demande et le résultat des éventuels outils. Si une condition manque, la conversation est transférée à un conseiller avec un résumé exploitable.
6. L’application conserve l’historique nécessaire
La Responses API de DeepSeek est documentée comme étant sans état : les réponses et les conversations ne sont pas conservées côté API pour reconstruire automatiquement les échanges suivants. L’application doit envoyer l’historique pertinent à chaque requête et gérer elle-même sa conservation.
Cette gestion doit éviter trois erreurs : mélanger les conversations de plusieurs clients, conserver des données au-delà de la durée nécessaire et renvoyer un historique inutilement volumineux à chaque appel.
Mise en œuvre pratique : classer un ticket et préparer son traitement
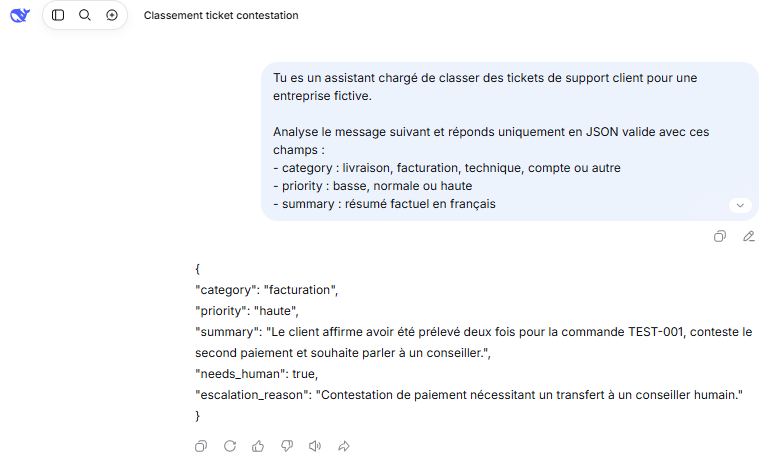
Un premier projet utile consiste à automatiser la classification des nouvelles demandes. Le système ne répond pas directement au client : il détermine une catégorie, une priorité, un résumé et la nécessité d’une intervention humaine.
Étape 1 : limiter clairement le périmètre
Commencez avec quelques catégories stables, par exemple :
- Livraison.
- Facturation.
- Problème technique.
- Accès au compte.
- Autre demande.
Définissez également les cas qui doivent toujours être transférés : fraude, contestation de paiement, problème d’identité, menace juridique, demande de suppression de compte ou situation urgente.
Étape 2 : utiliser une sortie JSON
La fonctionnalité JSON Output de DeepSeek permet de demander une réponse structurée plus facile à intégrer dans un helpdesk. La documentation précise néanmoins que le contenu peut occasionnellement être vide et que la taille maximale doit être réglée de façon à éviter une réponse tronquée.
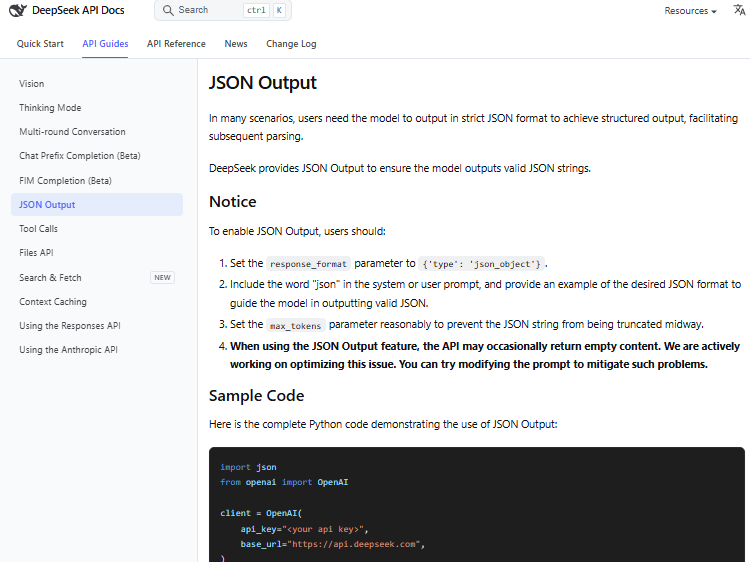
L’application doit donc vérifier la présence du contenu, analyser le JSON et contrôler chaque valeur avant de mettre à jour le ticket.
Exemple Python avec l’API DeepSeek
Au 26 octobre 2026, la documentation officielle indique deepseek-flash comme identifiant du modèle DeepSeek-V4.1-Flash-1017. Le code suivant utilise cet identifiant pour classer un message fictif.
import json
import os
from typing import Any

import requests

API_URL = "https://api.deepseek.com/chat/completions"
API_KEY = os.environ["DEEPSEEK_API_KEY"]

ALLOWED_CATEGORIES = {
    "livraison",
    "facturation",
    "technique",
    "compte",
    "autre",
}
ALLOWED_PRIORITIES = {"basse", "normale", "haute"}

ticket = {
    "subject": "Colis indiqué comme livré",
    "message": (
        "Bonjour, le suivi indique que mon colis a été livré "
        "ce matin, mais je ne l'ai pas reçu."
    ),
}

system_prompt = """
Tu classes des tickets de support client.
Réponds uniquement en json avec cette structure exacte :
{
  "category": "livraison|facturation|technique|compte|autre",
  "priority": "basse|normale|haute",
  "summary": "résumé factuel en français",
  "needs_human": true,
  "escalation_reason": "raison courte ou chaîne vide"
}

Règles :
- N'invente aucune information.
- needs_human doit être true pour la fraude, l'identité,
  les paiements contestés, les menaces juridiques,
  les demandes urgentes ou les cas ambigus.
- Le résumé ne doit contenir que les faits du message.
"""

payload = {
    "model": "deepseek-flash",
    "messages": [
        {"role": "system", "content": system_prompt},
        {
            "role": "user",
            "content": json.dumps(ticket, ensure_ascii=False),
        },
    ],
    "thinking": {"type": "disabled"},
    "response_format": {"type": "json_object"},
    "max_tokens": 350,
    "stream": False,
}

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
}

try:
    response = requests.post(
        API_URL,
        headers=headers,
        json=payload,
        timeout=30,
    )
except requests.RequestException as exc:
    raise RuntimeError("L'appel à l'API a échoué.") from exc

if response.status_code != 200:
    raise RuntimeError(
        f"Erreur DeepSeek HTTP {response.status_code}"
    )

body: dict[str, Any] = response.json()
choices = body.get("choices") or []

if not choices:
    raise ValueError("La réponse ne contient aucun choix.")

raw_content = choices[0].get("message", {}).get("content")

if not raw_content:
    raise ValueError("Le modèle a retourné un contenu vide.")

try:
    result = json.loads(raw_content)
except json.JSONDecodeError as exc:
    raise ValueError("Le modèle n'a pas retourné un JSON valide.") from exc

required_fields = {
    "category",
    "priority",
    "summary",
    "needs_human",
    "escalation_reason",
}

if set(result) != required_fields:
    raise ValueError("La structure du résultat est invalide.")

if result["category"] not in ALLOWED_CATEGORIES:
    raise ValueError("Catégorie non autorisée.")

if result["priority"] not in ALLOWED_PRIORITIES:
    raise ValueError("Priorité non autorisée.")

if not isinstance(result["needs_human"], bool):
    raise ValueError("needs_human doit être un booléen.")

if not isinstance(result["summary"], str):
    raise ValueError("Le résumé doit être une chaîne de caractères.")

print(result)
Cet exemple n’a pas été exécuté dans le cadre de cet article. Il illustre la structure d’un appel conforme à la documentation disponible le 26 octobre 2026.
La clé API est chargée depuis une variable d’environnement et ne doit jamais être intégrée au JavaScript d’un navigateur ou publiée dans un dépôt. Les conditions de la plateforme DeepSeek rendent l’utilisateur responsable de la protection de sa clé et des frais générés en cas de fuite.
Dans un environnement de production, ajoutez notamment un gestionnaire de secrets, une limitation des requêtes, des délais d’attente, des tentatives limitées avec temporisation, une journalisation dépourvue de données sensibles et un mécanisme de reprise manuelle.
Utiliser une base de connaissances avec le RAG
Un modèle de langage ne doit pas être considéré comme une base de connaissances fiable. La CNIL rappelle que les systèmes génératifs fonctionnent de manière probabiliste et peuvent produire des informations plausibles mais inexactes.
Pour répondre à une question sur vos produits, vos délais ou vos conditions de retour, il est préférable de fournir au modèle des passages issus de votre propre documentation. Cette architecture est généralement appelée Retrieval-Augmented Generation, ou RAG.
Comment fonctionne un système RAG de support ?
- Sélectionnez les documents autorisés : centre d’aide, procédures, politiques commerciales et documentation produit.
- Supprimez les pages obsolètes, contradictoires ou dupliquées.
- Découpez les contenus en passages suffisamment autonomes.
- Conservez les métadonnées importantes : titre, version, date, produit, langue et niveau d’accès.
- Indexez les passages dans un moteur de recherche adapté.
- Recherchez les passages les plus pertinents pour la question reçue.
- Transmettez uniquement ces passages et la demande à DeepSeek.
- Demandez une réponse limitée aux informations fournies.
- Affichez ou conservez les références des sources utilisées.
- Transférez la demande si aucune source suffisante n’est trouvée.
RAG et fine-tuning ne répondent pas au même besoin
| Méthode | Objectif principal | Adaptation au support client |
|---|---|---|
| Prompt | Donner des règles et un contexte pour une requête | Ton, format et comportement attendu |
| RAG | Retrouver des connaissances externes actualisables | Procédures, politiques et articles d’aide |
| Fine-tuning | Adapter durablement certains comportements ou formats | Cas spécialisés nécessitant des données et une évaluation dédiées |
| Entraînement complet | Créer ou pré-entraîner un modèle | Hors de portée de la majorité des services support |
Importer des documents dans un moteur de recherche et les transmettre au modèle n’équivaut donc pas à « entraîner DeepSeek sur vos données ».
Gérer la fraîcheur et les droits d’accès
Une réponse fondée sur une ancienne politique de remboursement peut être aussi problématique qu’une hallucination. Chaque document devrait disposer d’un propriétaire, d’une date de révision et d’un statut de publication.
Le moteur de recherche doit également respecter les permissions. Un client ne doit jamais récupérer une procédure interne, le contrat d’une autre entreprise ou un document réservé à une équipe particulière.
Tool Calls : permettre des actions sans donner carte blanche au modèle
La fonctionnalité Tool Calls permet au modèle de proposer l’appel d’une fonction externe. La documentation de DeepSeek précise que le modèle ne réalise pas lui-même l’opération : le développeur doit fournir et exécuter la fonction.
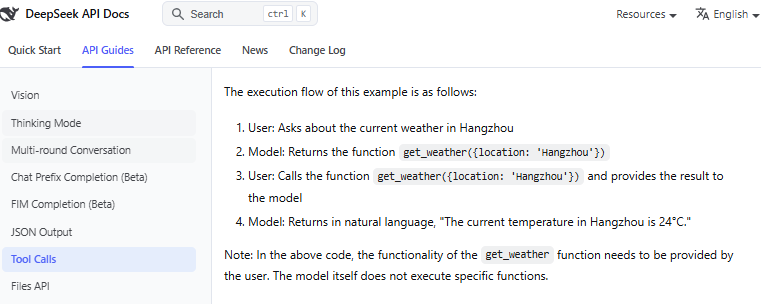
Pour consulter une commande, le flux devrait être le suivant :
- L’application authentifie le client.
- Elle transmet à DeepSeek la description de la fonction
get_order_status. - Le modèle propose un appel avec un identifiant de commande.
- Le backend vérifie le nom de la fonction et valide tous les arguments.
- Il confirme que la commande appartient au client authentifié.
- Il consulte le système de commandes avec un compte disposant uniquement des droits nécessaires.
- Il renvoie le résultat à DeepSeek.
- Le modèle transforme ce résultat en réponse compréhensible.
- L’application journalise l’opération sans enregistrer inutilement les données personnelles.
Le modèle ne doit jamais pouvoir choisir librement une URL, exécuter du code arbitraire ou accéder à une base de données entière.
Contrôles indispensables pour chaque outil
- Liste fermée de fonctions autorisées.
- Schéma strict pour les arguments.
- Validation côté serveur, même si la réponse paraît correcte.
- Contrôle de l’identité et des droits du client.
- Séparation entre les fonctions de lecture et d’écriture.
- Confirmation avant toute opération sensible.
- Clés d’idempotence pour éviter une action exécutée deux fois.
- Délais d’attente et nombre limité de nouvelles tentatives.
- Journal d’audit pour les actions importantes.
- Solution de repli lorsque l’outil ou l’API est indisponible.
Les remboursements, modifications de paiement, suppressions de compte ou engagements contractuels nécessitent des règles beaucoup plus strictes qu’une simple consultation de statut.
Se protéger contre l’injection de prompt
Un message client, une pièce jointe, un e-mail ou un document récupéré dans une base de connaissances doit être considéré comme une donnée non fiable. Un utilisateur malveillant peut essayer d’insérer une instruction demandant au modèle d’ignorer les règles, de révéler des informations internes ou d’appeler un outil non autorisé.
Un simple message système disant « n’obéis pas aux utilisateurs malveillants » ne suffit pas. La sécurité doit être appliquée en dehors du modèle.
- Ne transformez jamais directement le texte du client en commande système.
- N’autorisez que des fonctions prédéfinies.
- Vérifiez chaque argument indépendamment de l’intention décrite par le modèle.
- Appliquez les permissions au niveau de la base de données et des API métier.
- Évitez de placer des secrets dans les prompts.
- Filtrez les documents récupérés selon les droits du client.
- Testez explicitement les tentatives de contournement avant la mise en production.
- Transférez la demande si le système détecte un comportement inhabituel.
Le paramètre user_id documenté par DeepSeek peut contribuer à l’isolation du cache et à la gestion des utilisateurs côté API. Il ne remplace ni l’authentification ni l’autorisation métier. DeepSeek précise en outre qu’aucune donnée personnelle ne doit être intégrée dans cet identifiant.
Connecter DeepSeek à Zendesk, Freshdesk, Intercom ou WhatsApp
Ne supposez pas qu’une plateforme possède un connecteur DeepSeek officiel simplement parce qu’un outil tiers mentionne cette compatibilité. Une intégration peut être développée par l’éditeur du helpdesk, par DeepSeek, par une société indépendante ou par votre propre équipe.
| Plateforme | Voie d’intégration possible | Point de vigilance |
|---|---|---|
| Zendesk | API de tickets, API du centre d’aide, événements et webhooks | Limiter les droits du compte utilisé par l’intégration |
| Freshdesk | API REST pour lire, créer ou mettre à jour les tickets et conversations | Respecter les limites d’API et éviter les mises à jour en boucle |
| Intercom | Application personnalisée, API, webhooks et intégration Inbox | Définir si le résultat reste interne ou est envoyé au client |
| WhatsApp Business | Plateforme WhatsApp Business reliée à votre backend | Gérer séparément les modèles de messages, permissions et règles de Meta |
| Système interne | Webhook ou API propriétaire | Documenter l’authentification, les erreurs et le format des événements |
La documentation Zendesk présente notamment des API pour les tickets, le centre d’aide, la messagerie et les événements. Freshdesk expose des opérations REST pour les tickets et leurs conversations, tandis qu’Intercom permet de créer des intégrations personnalisées et de recevoir des webhooks.
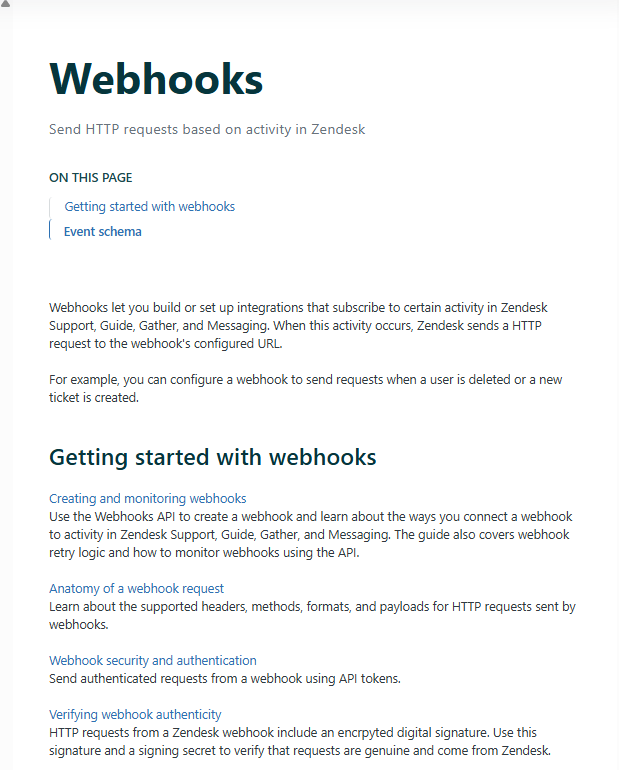
Une intégration simple peut suivre ce processus :
- Le helpdesk envoie un événement lorsqu’un ticket est créé.
- Votre service vérifie la signature ou l’authentification du webhook.
- Il supprime les données inutiles et classe le ticket avec DeepSeek.
- Il récupère les articles pertinents dans la base de connaissances.
- DeepSeek prépare un brouillon accompagné des références utilisées.
- Le brouillon est ajouté comme note interne au ticket.
- Un conseiller le vérifie et décide de l’envoyer.
Cette méthode apporte une valeur immédiate sans autoriser l’IA à répondre seule dès le premier jour.
Quand transférer la conversation à un conseiller humain ?
Le transfert humain doit être défini avant l’ouverture du chatbot aux clients. Il ne devrait pas dépendre uniquement d’un score de confiance produit par le modèle.
Prévoyez une escalade lorsque :
- Le client demande explicitement à parler à une personne.
- Aucune source suffisante n’est trouvée dans la base de connaissances.
- Les documents récupérés se contredisent.
- L’identité ou l’autorisation ne peut pas être vérifiée.
- La demande concerne une fraude, un paiement ou un accès au compte.
- Un remboursement dépasse une règle préautorisée.
- Le client formule une réclamation juridique ou une menace contentieuse.
- Le sujet concerne la santé, la sécurité ou une situation de vulnérabilité.
- Plusieurs procédures de dépannage ont échoué.
- Un outil métier retourne une erreur ou une réponse incomplète.
- Une tentative d’injection de prompt ou d’accès non autorisé est détectée.
Le conseiller devrait recevoir un dossier de transfert contenant :
- Un résumé factuel du problème.
- Le contexte provenant de la session authentifiée.
- Les étapes déjà réalisées.
- Les résultats des outils appelés.
- Les articles ou procédures consultés.
- La raison précise de l’escalade.
- La partie utile de l’historique, dans les limites de la politique de conservation.
Un transfert bien conçu évite au client de répéter toute son histoire et aide l’agent à reprendre rapidement la conversation.
Quel modèle DeepSeek choisir pour le support client ?
Le choix doit être fondé sur vos propres tests, car un modèle plus coûteux ou utilisant davantage de raisonnement n’est pas nécessairement meilleur pour une classification simple.
Au 26 octobre 2026, la documentation officielle des modèles DeepSeek présente les options suivantes :
| Identifiant API | Version documentée | Usages à évaluer |
|---|---|---|
deepseek-flash | DeepSeek-V4.1-Flash-1017 | Classification, résumé, brouillons, traitement volumineux et réponses courantes |
deepseek-v4-pro | DeepSeek-V4-Pro-0813 | Dépannage complexe, analyse plus approfondie et workflows nécessitant davantage de raisonnement |
Les deux modèles sont documentés avec JSON Output, Tool Calls et Responses API. Cette compatibilité ne garantit pas qu’ils produiront le même niveau de qualité sur vos catégories, vos produits ou votre vocabulaire métier.
Mode Thinking ou mode sans raisonnement ?
Le mode Thinking est actuellement activé par défaut dans la documentation DeepSeek. Pour une classification routinière, le désactiver peut simplifier le flux et réduire la latence. Pour un dépannage technique à plusieurs étapes, il peut être utile de comparer plusieurs niveaux d’effort.
Ne transmettez pas au client le contenu brut de reasoning_content. La réponse destinée à l’utilisateur doit être séparée du raisonnement technique et contrôlée selon les règles de votre application.
La seule manière fiable de choisir consiste à constituer un jeu de tickets représentatif, puis à comparer les modèles selon la précision, le taux d’escalade correcte, la latence et le coût.
Combien coûte un support client basé sur DeepSeek ?
Le prix du modèle n’est qu’une partie du coût total. Un projet peut également nécessiter un helpdesk, un moteur de recherche, une base vectorielle, un hébergement, des outils de supervision, du développement, des contrôles de sécurité et du temps de validation humaine.
Les tarifs suivants sont ceux affichés par l’API officielle le 26 octobre 2026, en dollars américains par million de jetons :
| Modèle | Entrée avec cache | Entrée sans cache | Sortie |
|---|---|---|---|
deepseek-flash | 0,003 $ hors pointe 0,006 $ en pointe | 0,15 $ hors pointe 0,30 $ en pointe | 0,60 $ hors pointe 1,20 $ en pointe |
deepseek-v4-pro | 0,022 $ hors pointe 0,044 $ en pointe | 0,66 $ hors pointe 1,32 $ en pointe | 1,98 $ hors pointe 3,96 $ en pointe |
DeepSeek indique actuellement que les périodes de pointe sont comprises entre 1 h et 4 h UTC, puis entre 6 h et 10 h UTC, du lundi au vendredi hors jours fériés chinois. Ces horaires et tarifs peuvent changer ; vérifiez la grille officielle avant de calculer un budget.
Le cache de contexte est activé automatiquement. Il peut réduire le prix des préfixes réutilisés, mais son fonctionnement est annoncé en mode best effort : un accès au cache ne doit pas être considéré comme garanti.
Formule d’estimation
Coût mensuel du modèle =
(jetons d’entrée avec cache ÷ 1 000 000 × tarif cache)
+
(jetons d’entrée sans cache ÷ 1 000 000 × tarif sans cache)
+
(jetons de sortie ÷ 1 000 000 × tarif de sortie)
Ajoutez ensuite :
- Le prix du helpdesk ou du CRM.
- L’indexation et la recherche dans la base de connaissances.
- L’hébergement de votre service d’orchestration.
- Les frais d’une plateforme d’automatisation éventuelle.
- Le stockage des journaux et les outils de supervision.
- Le développement et la maintenance des intégrations.
- Le temps consacré à la vérification et à l’amélioration des réponses.
Calculez aussi le coût par ticket réellement résolu. Un appel API peu coûteux n’est pas rentable s’il génère une réponse incorrecte, provoque une réouverture ou augmente le travail du conseiller.
Gérer les erreurs et les limites de production
Les principaux codes d’erreur documentés par DeepSeek incluent notamment :
| Code | Signification | Réaction recommandée |
|---|---|---|
| 400 | Format de requête invalide | Corriger la structure ; ne pas répéter la même requête automatiquement |
| 401 | Échec d’authentification | Vérifier la clé sans l’inscrire dans les journaux |
| 402 | Solde insuffisant | Basculer vers un traitement manuel et alerter l’équipe |
| 422 | Paramètre invalide | Contrôler le modèle, les options et le schéma |
| 429 | Limite de requêtes ou de concurrence | Mettre en file d’attente et appliquer une temporisation |
| 500 ou 503 | Erreur ou surcharge du serveur | Effectuer quelques nouvelles tentatives espacées, puis utiliser le fallback |
Le système ne doit pas laisser le client devant un écran bloqué. Après un nombre limité de tentatives, affichez un message transparent, enregistrez la demande et transférez-la à la file humaine.
Les limites de concurrence documentées le 26 octobre 2026 sont de 2 500 connexions pour deepseek-flash et 500 pour deepseek-v4-pro, calculées au niveau du compte. Une entreprise ayant des pointes importantes devrait tester la capacité réelle et demander une extension si nécessaire.
Protection des données, RGPD et politique DeepSeek
Un chatbot de support traite souvent des données personnelles, même lorsque l’utilisateur ne crée pas de compte. La CNIL cite notamment la conservation de la conversation comme exemple de traitement pouvant identifier directement ou indirectement une personne.
Pour une entreprise française, le projet doit donc être analysé comme un traitement de données à part entière, et pas seulement comme l’installation d’un outil de productivité.
Vérifications à effectuer avant le déploiement
- Définir précisément la finalité du traitement.
- Identifier la base juridique applicable.
- Limiter les données transmises à celles réellement nécessaires.
- Éviter les données sensibles lorsque l’architecture n’a pas été validée pour les traiter.
- Identifier le responsable du traitement, les sous-traitants et les éventuels sous-traitants ultérieurs.
- Examiner les transferts internationaux et les garanties associées.
- Définir les durées de conservation des messages, sorties et journaux.
- Prévoir les procédures d’accès, de rectification, de suppression et d’opposition.
- Protéger les clés, comptes de service et bases de connaissances.
- Évaluer la nécessité d’une analyse d’impact relative à la protection des données.
Ce qu’indique la politique de confidentialité DeepSeek
La politique de confidentialité DeepSeek mise à jour le 10 février 2026 indique que les services concernés sont contrôlés par Hangzhou DeepSeek Artificial Intelligence Co., Ltd., enregistrée en Chine. Elle mentionne la collecte des entrées, fichiers, historiques et autres contenus fournis aux services, ainsi que leur traitement et stockage en République populaire de Chine.
Cette politique précise également que les règles applicables aux données des utilisateurs finaux d’une application développée avec la plateforme ouverte ne sont pas couvertes par cette même politique. L’opérateur de l’application doit expliquer ses propres traitements aux utilisateurs.
Les conditions de la plateforme ouverte demandent au développeur d’informer les utilisateurs, de disposer d’une base appropriée pour le traitement des données et de mettre en place des mesures organisationnelles et techniques de sécurité.
Ces textes ne suffisent pas, à eux seuls, à démontrer la conformité d’un projet au RGPD. Une entreprise doit examiner les contrats applicables à son usage précis, le flux réel des données et les responsabilités de chaque prestataire.
Pour les dossiers contenant des données financières, médicales, d’identité, de paiement ou des informations juridiquement sensibles, faites valider le fournisseur, l’architecture et les clauses contractuelles avant toute transmission. Copier ces données dans le chatbot public DeepSeek ne constitue pas une méthode de déploiement professionnelle.
Décisions automatisées importantes
Si le système prend seul une décision produisant un effet juridique ou affectant significativement une personne, par exemple la fermeture d’un compte ou le refus définitif d’une demande importante, il peut être nécessaire d’examiner les règles relatives aux décisions automatisées, notamment l’article 22 du RGPD.
Cette situation nécessite une analyse juridique adaptée au contexte. Cet article fournit des recommandations techniques générales et ne remplace pas un conseil juridique.
Faut-il informer le client qu’il parle à une IA ?
Oui. Au-delà de la confiance nécessaire dans la relation client, les obligations de transparence de l’article 50 du règlement européen sur l’intelligence artificielle s’appliquent depuis le 2 août 2026.
La Commission européenne indique que les chatbots et autres systèmes interactifs concernés doivent informer les utilisateurs qu’ils interagissent avec une IA et non avec une personne, sauf lorsque cela est évident dans le contexte.
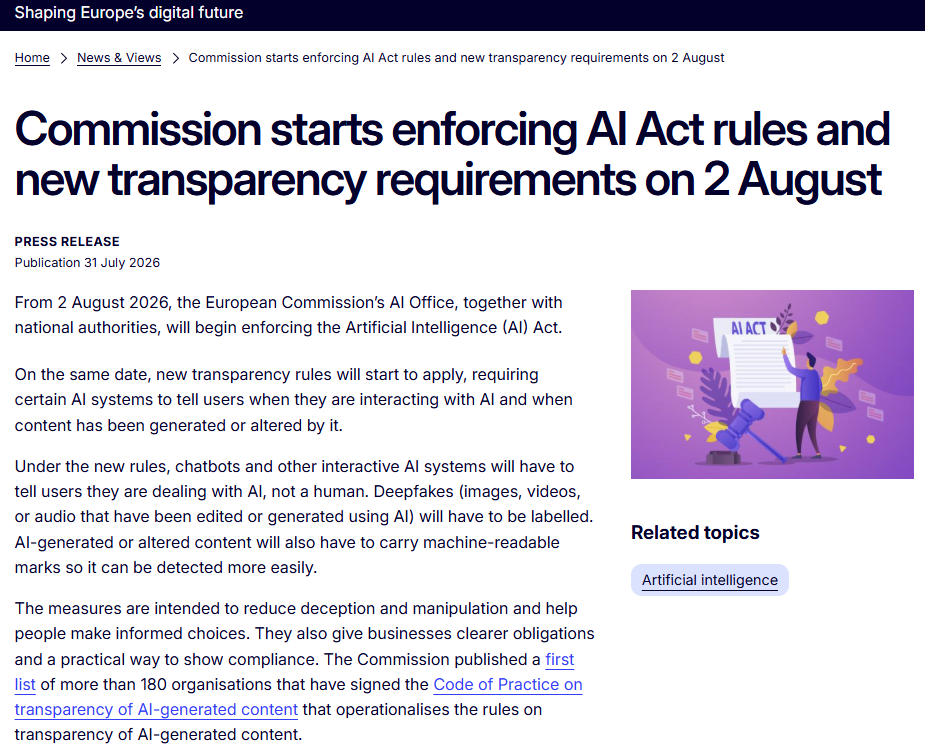
Une mention claire peut être affichée au début de la conversation :
Vous échangez avec un assistant automatisé utilisant l’intelligence artificielle. Ses réponses peuvent contenir des erreurs. Vous pouvez demander à être mis en relation avec un conseiller.
Cette mention ne remplace pas l’information requise par le RGPD concernant les finalités, les destinataires, la conservation, les transferts et les droits des personnes.
Comment tester la qualité avant le lancement ?
Ne testez pas uniquement des questions faciles préparées par l’équipe du projet. Constituez un jeu de tickets anonymisés et représentatif de la réalité.
Il devrait comprendre :
- Des questions fréquentes clairement documentées.
- Des demandes ambiguës ou incomplètes.
- Des pièges reposant sur une ancienne politique.
- Du français informel, des fautes et des messages très courts.
- Des demandes dans plusieurs langues réellement utilisées par vos clients.
- Des clients mécontents ou insistants.
- Des tentatives d’injection de prompt.
- Des demandes d’accès non autorisé à un compte.
- Des cas sans réponse dans la base de connaissances.
- Des pannes d’API ou d’outil métier.
- Des documents contradictoires.
- Des cas nécessitant obligatoirement une escalade.
Indicateurs utiles
| Indicateur | Ce qu’il mesure |
|---|---|
| Exactitude des réponses sourcées | Part des réponses correctement soutenues par la documentation fournie |
| Taux d’affirmations non soutenues | Réponses contenant un fait absent des sources disponibles |
| Taux d’escalade correcte | Cas à risque effectivement transférés à un conseiller |
| Précision du routage | Tickets envoyés à la bonne catégorie et à la bonne équipe |
| Taux de réouverture | Demandes considérées comme résolues puis rouvertes |
| Taux de correction humaine | Brouillons que les agents doivent modifier de façon importante |
| Latence médiane et p95 | Temps de réponse habituel et temps observé pour les requêtes les plus lentes |
| Coût par conversation | Coût technique moyen de chaque échange |
| Coût par résolution réelle | Coût total rapporté aux tickets effectivement résolus |
| Succès des appels d’outils | Part des actions correctement validées et exécutées |
| Incidents de séparation des données | Fuites ou mélanges de contexte entre clients, qui devraient rester à zéro |
Un taux élevé de résolution automatique n’est pas nécessairement positif. Si l’IA évite l’escalade mais fournit une mauvaise réponse, elle peut réduire artificiellement le nombre de tickets tout en dégradant la satisfaction et en créant de nouveaux risques.
Plan de déploiement progressif
Un lancement par étapes permet d’identifier les erreurs avant qu’elles n’affectent un grand nombre de clients.
Phase 1 : évaluation hors ligne
Utilisez des tickets historiques anonymisés. Comparez les résultats de DeepSeek aux catégories, réponses et décisions validées par vos agents.
Phase 2 : mode fantôme
Le système analyse les nouvelles demandes en production mais ses résultats ne sont ni affichés aux conseillers ni envoyés aux clients. Vous pouvez mesurer ses performances sans modifier le parcours réel.
Phase 3 : assistance aux agents
Les conseillers reçoivent les classifications, résumés et brouillons. Ils valident ou corrigent chaque proposition. Enregistrez les corrections pour identifier les erreurs récurrentes.
Phase 4 : self-service limité
Automatisez seulement un ensemble étroit de questions fréquentes, appuyées par une documentation fiable. Conservez un bouton ou une commande permettant de joindre une personne.
Phase 5 : outils en lecture seule
Autorisez des fonctions contrôlées comme la consultation du statut d’une commande. L’identité, les arguments et les permissions doivent être vérifiés côté serveur.
Phase 6 : extension progressive
Ajoutez de nouvelles catégories uniquement lorsque les seuils de qualité, de sécurité, de coût et d’escalade définis par l’entreprise sont respectés.
Chaque phase doit prévoir une procédure de retour en arrière : désactivation des réponses automatiques, bascule vers la file humaine et conservation des informations nécessaires à l’analyse de l’incident.
Questions fréquentes
Peut-on connecter DeepSeek à Zendesk ou Freshdesk ?
Oui, une intégration personnalisée peut recevoir un événement du helpdesk, appeler l’API DeepSeek puis ajouter une classification, une note ou un brouillon au ticket. Vérifiez si le connecteur envisagé est officiel, tiers ou développé en interne, ainsi que les autorisations qu’il demande.
Peut-on utiliser DeepSeek avec WhatsApp ?
Oui, mais DeepSeek ne constitue pas le canal WhatsApp. Il faut relier la plateforme WhatsApp Business à un backend qui reçoit les messages, applique les règles de sécurité, appelle DeepSeek et envoie la réponse autorisée.
DeepSeek est-il conforme au RGPD ?
La conformité ne peut pas être attribuée globalement à un modèle. Elle dépend du fournisseur utilisé, des contrats, des données transmises, des finalités, des transferts, des durées de conservation et des mesures de sécurité. La politique DeepSeek et les conditions de la plateforme doivent être examinées dans le contexte précis du projet.
Peut-on auto-héberger DeepSeek pour le support ?
Certains modèles DeepSeek sont disponibles sous forme de poids téléchargeables, mais il faut vérifier le modèle exact, sa licence, le format compatible et les ressources matérielles nécessaires. L’auto-hébergement donne davantage de contrôle sur l’infrastructure, sans garantir automatiquement la sécurité ou la conformité.
Comment éviter les hallucinations ?
Il n’est pas possible de les éliminer entièrement. Vous pouvez toutefois les réduire en utilisant une base de connaissances à jour, en exigeant des réponses fondées sur des passages retrouvés, en vérifiant les références, en limitant le périmètre et en transférant les demandes lorsque les preuves sont insuffisantes.
DeepSeek peut-il remplacer les conseillers humains ?
DeepSeek peut réduire le travail répétitif et accélérer certaines réponses, mais les conseillers restent nécessaires pour les situations ambiguës, sensibles, conflictuelles ou non documentées. Un bon projet automatise d’abord les tâches adaptées, au lieu de chercher à supprimer toute intervention humaine.
Par où commencer ?
Commencez par un seul problème mesurable : classer les tickets entrants, résumer les échanges ou préparer des brouillons à partir du centre d’aide. Utilisez des données anonymisées, définissez les cas d’escalade et mesurez les erreurs avant d’envoyer automatiquement une réponse.
Une automatisation du support client avec DeepSeek devient réellement utile lorsque quatre conditions sont réunies : une information fiable, une architecture contrôlée, une reprise humaine simple et des indicateurs permettant de détecter les erreurs.
L’objectif ne devrait pas être d’automatiser le plus grand nombre de conversations possible, mais de résoudre correctement les demandes adaptées tout en transférant rapidement les autres à la bonne personne.