
DeepSeek OCR et DeepSeek OCR-2 sont des modèles de reconnaissance et d’analyse documentaire capables de transformer l’image d’une page en texte ou en contenu structuré. Ils peuvent notamment servir à transcrire un document scanné, retrouver son ordre de lecture ou produire du Markdown. Leurs poids et leurs instructions d’utilisation sont disponibles dans les dépôts officiels DeepSeek-OCR et DeepSeek-OCR-2.
OCR-2 ne remplace pas automatiquement tous les outils d’extraction de PDF. Si votre document possède déjà un texte correctement exploitable, une extraction directe peut suffire. Pour un scan, l’OCR devient utile, mais les nombres, tableaux et passages difficiles doivent être contrôlés avant toute utilisation professionnelle.
Ce guide compare les deux générations, présente les méthodes d’accès et propose un programme Python pour traiter une image, puis un PDF page par page. L’objectif est d’obtenir une transcription vérifiable, pas simplement un fichier qui semble bien présenté.
Vérification éditoriale : 29 octobre 2026. Guide indépendant, non affilié à DeepSeek. Le code a fait l’objet de tests locaux de préparation et de traitement des réponses simulées ; aucune inférence DeepSeek OCR sur GPU n’a été exécutée pour cet article.
DeepSeek OCR ou OCR-2 : quelles différences ?
Le journal du projet original situe le lancement de DeepSeek-OCR au 20 octobre 2025 et annonce OCR-2 le 27 janvier 2026. Le rapport scientifique d’OCR-2 porte, lui, la date du 28 janvier : publication du modèle et publication du document de recherche ne sont pas nécessairement simultanées.
| Critère | DeepSeek-OCR | DeepSeek-OCR-2 |
|---|---|---|
| Génération | Première version, octobre 2025. | Deuxième version, janvier 2026. |
| Encodeur visuel | DeepEncoder. | DeepEncoder V2 et Visual Causal Flow. |
| Orientation de recherche | Compression du contexte textuel à travers sa représentation visuelle. | Amélioration de l’organisation des informations visuelles avant leur décodage. |
| Identifiant officiel des poids | deepseek-ai/DeepSeek-OCR | deepseek-ai/DeepSeek-OCR-2 |
| Licence publiée | MIT. | Apache 2.0. |
| Choix pratique | Conserver une intégration validée ou essayer la distribution Ollama documentée. | Évaluer la génération suivante sur ses propres documents avec un moteur compatible. |
Les licences sont indiquées dans les fiches officielles DeepSeek-OCR et DeepSeek-OCR-2. La présence d’un successeur ne signifie pas que les poids du premier modèle ont disparu ni que ses résultats deviennent inutilisables.
Pourquoi l’ordre de lecture est-il important ?
Sur une page à plusieurs colonnes, reconnaître les bons mots ne suffit pas : il faut aussi les restituer dans un ordre cohérent. Le rapport DeepSeek-OCR 2 présente DeepEncoder V2 comme une manière de réorganiser les informations visuelles selon le contenu avant leur interprétation par le modèle de langage.
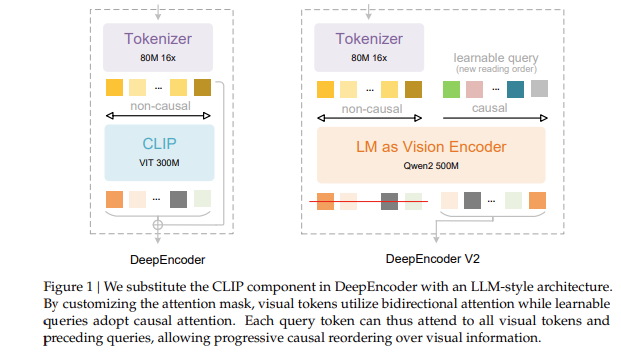
C’est particulièrement pertinent pour examiner des colonnes, encadrés ou tableaux. Il ne faut toutefois pas transformer cette proposition architecturale en promesse de lecture parfaite sur toutes les mises en page.
La compression optique ne réduit pas votre PDF comme un fichier ZIP
Le premier rapport DeepSeek-OCR étudie la représentation de textes sous forme d’images, puis leur décodage à partir de jetons visuels. Il annonce environ 97 % de précision dans une expérience où le rapport entre jetons textuels et visuels reste inférieur à dix.
Ce résultat ne signifie ni « 97 % de précision sur tous les documents », ni « PDF dix fois plus petit », ni « facture API divisée par dix ». Il décrit une expérience particulière de compression du contexte pour le modèle.
Quels résultats peut-on obtenir : texte, Markdown et tableaux ?
La fiche officielle d’OCR-2 distingue notamment une transcription sans mise en page et une conversion documentaire vers Markdown. Les consignes publiées comprennent :
# Transcription sans structure de mise en page
<image>\nFree OCR.

# Conversion documentaire avec informations de structure
<image>\n<|grounding|>Convert the document to markdown.
Dans une chaîne Python, \n représente un retour à la ligne. Conservez les marqueurs et la formulation adaptés au moteur choisi. « Free OCR. » est une consigne de traitement, pas une indication de gratuité commerciale.
Avec la conversion structurée, le résultat peut contenir des titres, du texte, des tableaux ou des marqueurs de localisation. La documentation Transformers montre notamment des balises <|ref|> et <|det|> associées à l’identification et à la position d’éléments.
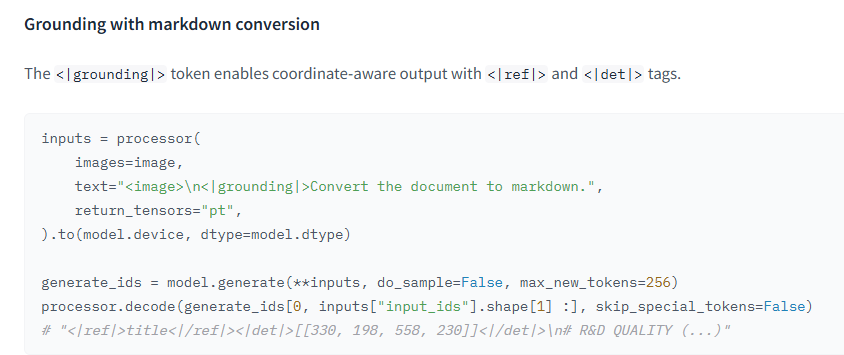
Ce résultat n’est pas automatiquement un fichier Excel, un JSON valide ou un PDF dans lequel on peut rechercher du texte. Un tableau reconnu demande encore une vérification des cellules, et sa conversion en CSV ou XLSX constitue une étape distincte.
Gardez également séparées la transcription et l’interprétation. Lire « 1 250,00 € » dans une facture, décider à quel champ comptable rattacher ce montant et produire une synthèse sont trois opérations différentes.
Comment accéder aux modèles sans confondre les services ?
Les poids, le moteur qui les exécute et l’interface utilisée sont des composants distincts. Choisissez un parcours documenté pour la génération souhaitée.
| Parcours | À quoi sert-il ? | Vérification essentielle |
|---|---|---|
| Code d’inférence du dépôt DeepSeek | Exécuter l’implémentation publiée par le développeur. | Respecter ses dépendances et son contrat de sortie. |
| vLLM | Traiter des images localement ou servir un modèle dans votre infrastructure. | Utiliser la recette correspondant exactement à OCR ou OCR-2. |
| Transformers | Intégrer le modèle dans un programme Python. | Distinguer le code personnalisé d’origine de l’intégration native et de ses poids convertis. |
| Ollama | Essayer la distribution locale DeepSeek-OCR répertoriée dans sa bibliothèque. | Ne pas la présenter comme OCR-2. |
| Hébergement tiers | Utiliser une API sans administrer directement les GPU. | Contrôler le modèle servi, les tarifs, les limites et le traitement des documents. |
La fiche Ollama de DeepSeek-OCR documente la première génération et demande Ollama 0.13.0 ou une version ultérieure. Cette disponibilité ne démontre pas l’existence d’un tag officiel OCR-2 équivalent.
Dans Transformers, l’intégration documentée avec AutoProcessor et AutoModelForImageTextToText utilise deepseek-community/DeepSeek-OCR-2. Elle ne doit pas être mélangée à l’exemple du dépôt original utilisant AutoModel et model.infer.
Enfin, le catalogue de l’API DeepSeek officielle consulté le 29 octobre 2026 ne présente pas OCR ou OCR-2 comme modèles autonomes dans sa liste de modèles hébergés. N’envoyez pas un identifiant Hugging Face à api.deepseek.com sans documentation confirmant sa prise en charge. Un serveur vLLM local ou une API tierce représente un autre service.
Tutoriel : utiliser DeepSeek OCR-2 avec Python et vLLM
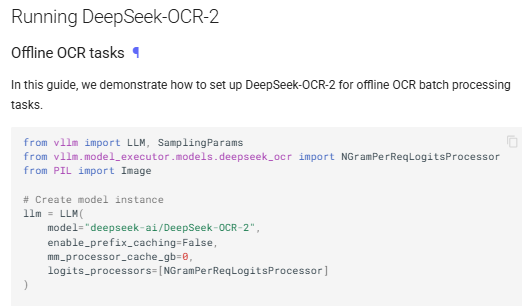
Le parcours suivant utilise le modèle officiel OCR-2 avec l’intégration native de vLLM. Il commence par une image, puis accepte un PDF dont les pages sont converties en images avant l’inférence. Il ne dépend pas du compte API DeepSeek.
1. Préparer un environnement compatible
Ce parcours vise Linux, Python 3.12 et un GPU NVIDIA compatible avec l’environnement CUDA et le format du modèle. Vérifiez les pilotes et prérequis dans le guide d’installation GPU de vLLM. Il ne s’agit pas d’une procédure native Windows ou d’une promesse de fonctionnement sur n’importe quel ordinateur portable.
La fiche de recette vLLM annonce la prise en charge d’OCR-2 à partir de la version 0.16.0. Après avoir installé uv, créez un environnement séparé :
uv venv --python 3.12
source .venv/bin/activate
uv pip install -U "vllm>=0.16.0" pillow pypdfium2 --torch-backend auto
uv pip freeze > versions-ocr.txt
Ne mélangez pas cet environnement avec les anciennes dépendances épinglées dans les exemples Transformers du dépôt DeepSeek. vLLM recommande un environnement neuf, notamment pour éviter des incompatibilités entre ses composants compilés, CUDA et PyTorch.
2. Préparer une page de test
Commencez avec une image PNG ou JPEG non confidentielle : par exemple, une page que vous avez créée avec un titre, quelques phrases françaises et un petit tableau de nombres fictifs. Conservez le document original pour vérifier la transcription.
Le programme fixe une révision vérifiée du dépôt officiel. Les options d’inférence s’appuient sur la recette OCR-2 de vLLM, notamment son mécanisme de contrôle des répétitions.
3. Créer le programme de transcription
Enregistrez ce code dans ocr_document.py. Il charge le modèle une fois, traite une page à la fois et conserve les résultats bruts avec leur numéro de page. Il refuse d’écraser un dossier existant.
import argparse
import json
from contextlib import closing
from pathlib import Path

import pypdfium2 as pdfium
from PIL import Image, ImageOps

MODELE = "deepseek-ai/DeepSeek-OCR-2"
REVISION = "aaa02f3811945a91062062994c5c4a3f4c0af2b0"
PROMPT = "<image>\n<|grounding|>Convert the document to markdown. "


def pages(source: Path, dpi: int):
    if source.suffix.lower() == ".pdf":
        with pdfium.PdfDocument(source) as document:
            document.init_forms()
            if len(document) == 0:
                raise ValueError("PDF sans page.")
            for index in range(len(document)):
                with closing(document[index]) as page:
                    with closing(page.render(scale=dpi / 72)) as bitmap:
                        image = bitmap.to_pil().convert("RGB")
                try:
                    yield index + 1, image
                finally:
                    image.close()
    else:
        with Image.open(source) as original:
            if getattr(original, "n_frames", 1) != 1:
                raise ValueError("Exportez une image distincte par page.")
            image = ImageOps.exif_transpose(original).convert("RGB")
        try:
            yield 1, image
        finally:
            image.close()


def traiter(source: Path, dossier: Path, dpi: int = 200):
    if not source.is_file():
        raise FileNotFoundError("Fichier source introuvable.")
    if not 72 <= dpi <= 600:
        raise ValueError("Choisissez une resolution entre 72 et 600 dpi.")
    if dossier.exists():
        raise FileExistsError("Choisissez un nouveau dossier de sortie.")

    # Charger le moteur une seule fois pour le document.
    from vllm import LLM, SamplingParams
    from vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor

    dossier.mkdir(parents=True)
    moteur = LLM(
        model=MODELE,
        revision=REVISION,
        tokenizer_revision=REVISION,
        enable_prefix_caching=False,
        mm_processor_cache_gb=0,
        logits_processors=[NGramPerReqLogitsProcessor],
    )
    reglages = SamplingParams(
        temperature=0.0,
        max_tokens=8192,
        skip_special_tokens=False,
        extra_args={
            "ngram_size": 30,
            "window_size": 90,
            "whitelist_token_ids": {128821, 128822},
        },
    )
    fichiers = []
    with closing(pages(source, dpi)) as documents:
        for numero, image in documents:
            resultats = moteur.generate([
                {"prompt": PROMPT, "multi_modal_data": {"image": image}}
            ], reglages)
            if not resultats or not resultats[0].outputs:
                raise RuntimeError(f"Page {numero} : aucune sortie.")
            sortie = resultats[0].outputs[0]
            texte = sortie.text
            if not isinstance(texte, str):
                raise RuntimeError(f"Page {numero} : sortie non textuelle.")
            prefixe = dossier / f"page-{numero:04d}"
            prefixe.with_suffix(".raw.md").write_text(texte, encoding="utf-8")
            infos = {
                "source": source.name,
                "page": numero,
                "model": MODELE,
                "revision": REVISION,
                "dpi": dpi if source.suffix.lower() == ".pdf" else None,
                "finish_reason": sortie.finish_reason,
            }
            prefixe.with_suffix(".json").write_text(
                json.dumps(infos, ensure_ascii=False, indent=2), encoding="utf-8"
            )
            if sortie.finish_reason != "stop" or not texte.strip():
                raise RuntimeError(
                    f"Page {numero} a revoir : sortie vide ou interrompue."
                )
            fichiers.append((numero, prefixe.with_suffix(".raw.md")))
            print(f"Page {numero} enregistree ; verification humaine requise.")
    with (dossier / "document.raw.md").open("x", encoding="utf-8") as fusion:
        for numero, fichier in fichiers:
            fusion.write(f"\n\n<!-- Page {numero} -->\n\n")
            fusion.write(fichier.read_text(encoding="utf-8"))


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="OCR-2 : image ou PDF vers Markdown brut.")
    parser.add_argument("source", type=Path)
    parser.add_argument("dossier", type=Path)
    parser.add_argument("--dpi", type=int, default=200)
    args = parser.parse_args()
    try:
        traiter(args.source, args.dossier, args.dpi)
    except (OSError, ValueError, RuntimeError, ImportError) as erreur:
        raise SystemExit(str(erreur)) from None
4. Lancer une première image et contrôler les fichiers
python ocr_document.py page.png sortie-imageLe premier lancement nécessite de récupérer les fichiers du modèle s’ils ne sont pas déjà présents. Le programme produit page-0001.raw.md, un fichier de métadonnées page-0001.json et, si le traitement se termine normalement, document.raw.md.
Le contrôle de finish_reason, exposé dans les objets de sortie vLLM, permet de détecter notamment une génération interrompue. Il ne certifie pas que tous les mots ont été correctement reconnus.
Les balises sont volontairement conservées dans les fichiers bruts. Ne publiez pas directement cette sortie comme un document corrigé. Vérifiez le texte, les nombres et l’ordre de lecture avant de créer une version nettoyée.
Vérification du programme : la syntaxe et 19 tests locaux ont été validés avec Python 3.13.5, Pillow 12.3.0 et pypdfium2 5.8.0. Ils portent sur la préparation des images, le rendu PDF, les fichiers produits et des réponses de modèle simulées. Ils ne valident pas l’installation GPU, le chargement des poids ou la qualité de reconnaissance d’OCR-2.
Comment convertir un PDF scanné en Markdown ?
Avant de lancer l’OCR, essayez de sélectionner et d’extraire le texte du PDF. La documentation pypdf distingue les documents numériques, les scans et les fichiers possédant déjà une couche OCR. Pour un document numérique correctement extractible, repasser par des images peut ajouter inutilement une étape de reconnaissance.
Si le fichier nécessite effectivement un OCR, le programme précédent peut traiter ses pages :
python ocr_document.py scan.pdf sortie-pdf --dpi 200La bibliothèque pypdfium2 transforme chaque page en image ; le modèle reçoit ensuite cette image. Il ne lit donc pas directement le fichier PDF comme une entrée textuelle. Les pages sont rendues et traitées successivement, sans créer d’avance toutes les images en mémoire.
La résolution de 200 dpi est un point de départ choisi pour cet exemple, pas une valeur optimale universelle. La plage de 72 à 600 dpi est une limite du programme, non une règle DeepSeek. Comparez la lisibilité, le résultat et la consommation de ressources sur vos pages.
Le fichier assemblé conserve des séparateurs de pages. Il n’est créé que si toutes les générations se terminent sans erreur détectée. Une fusion de fichiers ne reconstitue cependant pas automatiquement les tableaux coupés entre deux pages, leurs en-têtes ou les renvois de notes.
Ce parcours ne crée pas un PDF interrogeable avec une couche de texte invisible. Il produit des transcriptions Markdown. L’ajout d’une couche textuelle alignée dans le PDF constitue une autre opération.
Quelle précision attendre, notamment sur des documents français ?
Les résultats publiés par DeepSeek
Le rapport OCR-2, tableaux 1 et 2, compare les deux générations sur OmniDocBench v1.5, constitué de 1 355 pages en chinois et en anglais.
| Mesure publiée | DeepSeek-OCR, configuration 9 découpes | DeepSeek-OCR-2 |
|---|---|---|
| Score global OmniDocBench, plus élevé préférable | 87,36 | 91,09 |
| Distance d’édition de l’ordre de lecture, plus faible préférable | 0,085 | 0,057 |
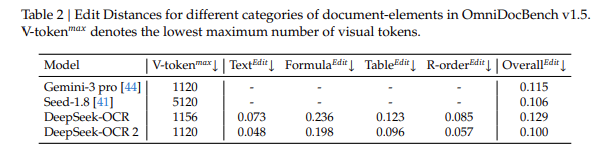
Le score global progresse de 3,73 points dans ce protocole. Il s’agit d’une mesure composite publiée par le développeur, pas d’une garantie de transcription exacte de 91,09 % des caractères de vos documents français.
Un benchmark français donne une autre perspective
Le jeu fr-bench-pdf2md, publié par des membres de Probayes et OpenValue, évalue des pages françaises volontairement difficiles : petits caractères, colonnes, longs tableaux et documents mêlant imprimé et manuscrit. Ses tests vérifient notamment la présence du texte, l’ordre de lecture et la structure.
Dans le tableau consulté le 29 octobre 2026, la colonne All categories affiche 0,377 pour DeepSeek-OCR et 0,242 pour OCR-2. OCR-2 n’y obtient donc pas le meilleur résultat des deux dans cette configuration.
Ces valeurs ne se comparent pas directement au score OmniDocBench : corpus, mesures et conditions diffèrent. Elles ne prouvent pas non plus que la première génération sera supérieure sur chaque document. Elles justifient surtout de tester les deux modèles avant une migration, particulièrement pour des archives françaises difficiles.
Comment vérifier une transcription avant de l’exploiter ?
Préparez un petit échantillon représentatif avant de lancer un traitement massif : une page imprimée propre, une page à plusieurs colonnes, un tableau et une page dégradée. Ce choix constitue une méthode d’évaluation recommandée, pas un jeu de tests exécuté ici sur DeepSeek.
- Contrôlez les caractères et valeurs : accents, ligatures, noms propres, dates, références, virgules décimales, séparateurs de milliers et symboles monétaires.
- Vérifiez les relations : ordre des colonnes, association d’un montant à sa ligne, titres, notes de bas de page et en-têtes des tableaux.
- Repérez les pertes et ajouts : paragraphes absents, lignes répétées, chiffres complétés sans justification ou contenu inventé.
- Conservez la preuve : gardez le fichier source, le numéro de page, la sortie brute et une version corrigée séparée.
Pour une facture, mesurez par exemple l’exactitude des champs importants plutôt que la seule lisibilité globale. Un document élégant peut rester inutilisable si un identifiant ou un montant est faux.
Pour l’écriture manuscrite, ne supposez pas une qualité comparable à l’imprimé. Le benchmark français signale des difficultés importantes sur ce type de contenu. Une valeur illisible doit rester à vérifier : ne demandez pas au modèle de la deviner.
Enfin, n’inventez pas un « score de confiance » à partir de la fluidité du résultat. Le programme présenté ne fournit aucune probabilité calibrée de justesse.
Quel matériel et quel budget faut-il prévoir ?
Le dépôt officiel d’OCR-2 représente environ 6,8 Go de fichiers à la date de vérification. Cette taille n’est pas un minimum de VRAM. L’exécution ajoute notamment les ressources du moteur, les activations, les données visuelles et le budget de génération.
Le dimensionnement dépend du runtime, de la précision des poids, du traitement des images, de la longueur de sortie et du nombre de pages simultanées. Ne déduisez pas la mémoire nécessaire d’une simple étiquette « 3B » ou du nombre de paramètres actifs.
Pour débuter, traitez une page à la fois et mesurez votre configuration avant de paralléliser. Une recommandation destinée à un serveur GPU ne constitue pas une garantie de fluidité sur CPU, Windows natif ou ordinateur portable.
Le budget comprend éventuellement le GPU, l’hébergement, l’électricité, le stockage, le prétraitement et la correction humaine. Les prix de l’API conversationnelle DeepSeek ne sont pas les tarifs d’un service OCR-2 indépendant. Si un prestataire héberge le modèle, utilisez sa grille propre et vérifiez ce qu’il facture : page, requête, durée de calcul ou autre unité.
Erreurs fréquentes et corrections utiles
Commencez par une seule page et conservez les versions installées. Le guide OCR-2 de vLLM et la documentation du moteur choisi doivent rester les références pour les paramètres d’inférence.
| Problème | Vérification et action |
|---|---|
| Import impossible ou incompatibilité CUDA | Contrôlez la version du runtime, les pilotes et l’environnement. Ne mélangez pas les dépendances d’anciennes recettes avec une installation récente. |
| Mémoire GPU insuffisante | Réduisez d’abord les traitements simultanés et vérifiez les autres processus. Mesurez ensuite les besoins de votre configuration plutôt que de supposer que la taille des poids suffit. |
| Le modèle répond sans transcrire la page | Vérifiez que l’image est réellement transmise et que le prompt correspond au runtime. Un chemin écrit dans une phrase n’attache pas automatiquement le fichier. |
| La sortie s’arrête au milieu d’un tableau | Inspectez la raison de fin et le budget de génération. Ne complétez pas la fin par supposition ; retravaillez la page ou son découpage. |
| Des lignes se répètent | Contrôlez le mécanisme anti-répétition recommandé, la qualité de l’image et la taille du contenu. Aucun réglage ne garantit la disparition de toutes les répétitions. |
| Des balises apparaissent dans le Markdown | Conservez la sortie brute. Interprétez les marqueurs avant de nettoyer une copie ; une suppression globale peut détruire des informations utiles. |
| Les colonnes ou les lignes sont mélangées | Comparez visuellement la page et sa transcription. Testez un autre mode ou un autre outil sur cet exemple avant un traitement massif. |
Le programme de ce guide interrompt volontairement le traitement lorsqu’une sortie est vide ou incomplète. Les fichiers déjà écrits restent disponibles pour le diagnostic, mais leur présence ne signifie pas que le document entier a été traité avec succès.
Licences, confidentialité et intégration dans un RAG
Les licences MIT du premier modèle et Apache 2.0 d’OCR-2 accordent des droits d’utilisation sous leurs conditions respectives. Examinez aussi les licences des bibliothèques et conversions utilisées, ainsi que vos droits sur les documents traités.
Avec certaines implémentations personnalisées, trust_remote_code=True autorise le chargement du code du dépôt, comme l’explique la documentation Transformers. Ne l’ajoutez pas mécaniquement : examinez la provenance, fixez une révision appropriée et utilisez un environnement isolé.
Pour des documents sensibles, vérifiez où s’exécutent l’inférence et les traitements annexes. Un service tiers ou une démonstration publique possède ses propres règles. Une exécution locale ne dispense pas d’examiner les téléchargements, journaux, accès réseau et composants connectés. Aucune licence de modèle ne garantit à elle seule la confidentialité ou la conformité au RGPD.
Pour un RAG, l’OCR fournit une matière première : il reste à organiser les passages, conserver les références de pages, appliquer les droits d’accès et vérifier les réponses produites à partir de ces données. Une transcription erronée peut être reproduite ensuite dans une réponse pourtant accompagnée d’une référence.
Traitez aussi les documents comme des contenus non fiables. Les recommandations OWASP sur l’injection de prompt couvrent les instructions malveillantes présentes dans des fichiers ou des images. Une phrase reconnue dans une page ne doit pas autoriser un agent à exécuter une commande ou divulguer un secret.
Quand choisir un autre outil ?
Pour un PDF numérique correctement extractible, commencez par l’extraction directe. Une bibliothèque telle que pypdf peut éviter de reconvertir en image un texte déjà présent, sous réserve de contrôler l’ordre et la structure obtenus.
Pour de l’imprimé courant, comparez un OCR classique. Tesseract possède un moteur multilingue utilisable en ligne de commande ou par API. Il ne faut pas affirmer qu’un outil classique ne peut jamais préserver d’informations de mise en page ; examinez son format de sortie et le traitement complet.
Pour une chaîne documentaire plus large, évaluez un outil d’orchestration. Docling organise la conversion de différents formats, l’analyse documentaire et l’export. Ce n’est pas simplement un autre nom pour un modèle OCR isolé.
DeepSeek OCR et OCR-2 méritent une évaluation lorsque vous souhaitez combiner reconnaissance et structure documentaire avec des poids déployables. Choisissez toutefois sur vos propres pages : la meilleure solution est celle qui conserve les informations nécessaires, permet de retrouver leur origine et demande un niveau de correction acceptable, pas nécessairement celle qui possède le numéro de version le plus élevé.