
DeepSeek en local vs API : privilégiez une API hébergée pour démarrer sans administrer le modèle, et envisagez le local lorsque le fonctionnement hors ligne, la maîtrise de l’infrastructure ou la conservation d’un checkpoint précis justifient cette responsabilité. Le choix dépend aussi du matériel disponible, des données traitées et du volume réel de travail.
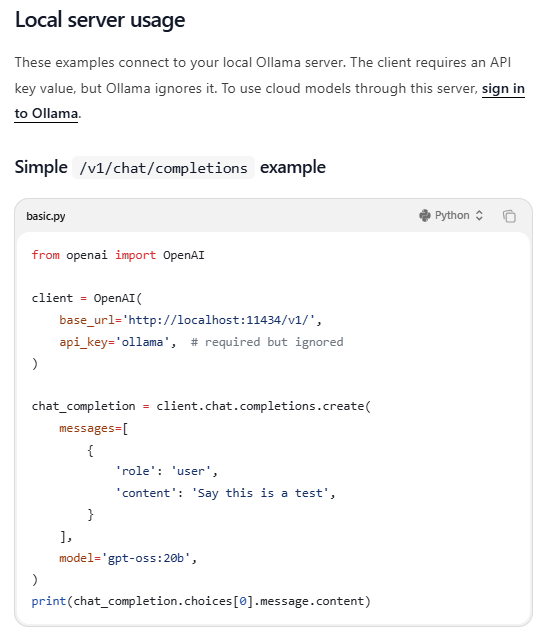
Une précision change toute la comparaison : un modèle local peut lui aussi être appelé par API. Ollama propose par exemple une interface compatible avec certains endpoints OpenAI sur votre machine. L’opposition pertinente est donc celle entre une inférence exécutée sur une infrastructure que vous administrez et une inférence réalisée par un fournisseur externe.
Documentation vérifiée le 29 octobre 2026.
DeepSeek local ou API hébergée : les différences essentielles
Le tableau suivant compare les responsabilités et les critères de choix. Il ne suppose pas que les deux environnements exécutent automatiquement le même modèle.
| Critère | Exécution locale ou auto-hébergée | API gérée par un fournisseur |
|---|---|---|
| Mise en route | Choisir les poids, installer un moteur et vérifier les ressources | Configurer un compte, une clé et l’appel au modèle |
| Coûts | Matériel ou location, énergie, stockage et exploitation | Consommation facturée et coûts de votre application |
| Données | Possibilité de maîtriser leur parcours, à condition de contrôler toute la chaîne | Transmission au fournisseur selon les conditions du service |
| Connexion Internet | Peut devenir facultative après installation, pour un workflow entièrement local | Nécessaire pour joindre le service distant |
| Performances | Dépendent du modèle, du matériel et de la configuration | Dépendent aussi du réseau, de la charge et des règles du service |
| Évolution du modèle | Vous choisissez les mises à jour et les versions conservées | Vous devez suivre les changements de modèles et d’alias |
| Exploitation | Supervision, sécurité et capacité à votre charge | Inférence administrée par le fournisseur ; intégration à votre charge |
Il existe également une option intermédiaire : louer un serveur GPU et administrer vous-même le modèle. C’est de l’auto-hébergement sur une infrastructure louée, pas une exécution sur votre ordinateur. Le fournisseur d’infrastructure, la localisation des données et les responsabilités de sécurité restent à examiner.
La documentation de compatibilité d’Ollama illustre bien cette distinction : un client peut appeler une interface locale ou une offre cloud. L’adresse de connexion et le modèle sélectionné déterminent le parcours effectif, pas simplement le nom de l’application installée.
Comparez d’abord les modèles, pas seulement leur emplacement
Une comparaison entre « DeepSeek sur mon PC » et « DeepSeek dans le cloud » peut masquer un écart beaucoup plus important : celui entre deux modèles différents.
Un DeepSeek-R1 8B local n’est pas le modèle complet
Dans le catalogue Ollama consulté, le tag deepseek-r1:8b correspond à une distribution de DeepSeek-R1-0528-Qwen3-8B. La fiche officielle DeepSeek explique que cette variante a été obtenue en adaptant Qwen3 8B à partir de raisonnements produits par R1-0528.
Il ne s’agit donc pas du grand modèle R1 complet simplement déplacé sur un ordinateur personnel. La distillation transmet certains comportements à un autre modèle. La quantification, elle, réduit la précision numérique de paramètres pour faciliter leur stockage et leur exécution. Ce sont deux opérations différentes.
À la date de vérification, l’identifiant officiel deepseek-flash sert DeepSeek-V4.1-Flash-1017, selon le changelog de DeepSeek. Comparer cette API à une variante R1 8B peut éclairer votre choix pratique, mais ne permet pas d’attribuer une différence de qualité au seul déploiement local.
Peut-on héberger le modèle correspondant à l’API ?
Il ne faut pas supposer que tous les modèles hébergés sont indisponibles au téléchargement. DeepSeek publie notamment le checkpoint DeepSeek-V4.1-Flash-1017 et des ressources d’inférence. Sa disponibilité ne garantit toutefois pas que votre machine possède les ressources nécessaires.
Pour étudier réellement l’effet du déploiement, comparez autant que possible le même checkpoint, avec une précision, un format de conversation et des réglages équivalents. Pour choisir entre deux solutions différentes, assumez au contraire cette différence et mesurez si chacune atteint votre niveau de qualité attendu.
Quel matériel faut-il pour exécuter DeepSeek en local ?
La première vérification n’est pas « ai-je assez de place pour télécharger le modèle ? », mais « puis-je l’exécuter avec le contexte et le nombre d’utilisateurs prévus ? »
Taille des fichiers, RAM et VRAM ne sont pas équivalentes
À titre d’exemple, les tags Ollama de R1-0528-Qwen3-8B affichent environ 5,2 Go pour la variante Q4_K_M, contre 16 Go pour la variante F16. Ces chiffres décrivent les distributions proposées, pas une garantie que la même quantité de mémoire suffira pendant une conversation.
La RAM est la mémoire principale de l’ordinateur ; la VRAM est celle d’un GPU dédié. Certains systèmes utilisent une mémoire unifiée. Pendant l’inférence, il faut accueillir les poids et les autres données de calcul, notamment le cache KV, qui conserve des informations utiles au traitement du contexte.
La documentation vLLM sur la mémoire montre que le contexte, la taille des lots et la quantification sont des leviers distincts. Un tableau universel « modèle 8B = tant de VRAM » serait donc trompeur sans préciser la configuration.
Pour un modèle MoE, le nombre de paramètres activés pendant un calcul ne correspond pas non plus à tous les poids à stocker ou à rendre accessibles. Une faible fraction active ne transforme pas automatiquement un très grand modèle en petit fichier.
Le contexte et la concurrence changent les besoins
La longueur maximale annoncée pour un modèle n’est pas nécessairement le contexte configuré dans votre moteur. Ollama explique qu’augmenter le contexte augmente la mémoire nécessaire. Plusieurs requêtes simultanées peuvent encore modifier la charge.
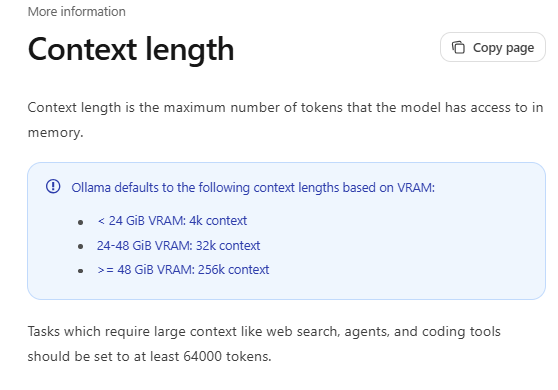
Testez donc un document représentatif, puis le nombre de demandes simultanées envisagé. Un modèle qui fonctionne sur une question courte peut se comporter différemment avec un historique long ou plusieurs utilisateurs. Pouvoir le charger ne prouve pas que le délai obtenu conviendra à votre application.
Performances : le local est-il plus rapide que l’API ?
Pas systématiquement. Supprimer le trajet réseau ne dit rien, à lui seul, du temps passé à charger les poids, traiter l’entrée et générer la réponse. À l’inverse, une infrastructure distante puissante peut aussi faire attendre une demande.
La documentation d’optimisation de vLLM distingue notamment le délai avant le premier token, la latence entre tokens et le débit. Améliorer une mesure ne garantit pas d’améliorer toutes les autres.
Pour votre comparaison, relevez séparément le temps avant la première réponse visible, la durée totale et le nombre de tâches terminées. Un débit agrégé élevé sur plusieurs utilisateurs n’est pas la vitesse reçue par une seule personne.
Gardez une trace du modèle, de sa quantification, du moteur, du contexte, de la longueur de sortie et du niveau de raisonnement. Séparez également les essais à froid des essais où le modèle est déjà chargé. Comparez enfin les erreurs et la qualité : une réponse rapide mais inutilisable ne constitue pas un avantage.
Pour des usages francophones, incluez vos propres tâches en français. Ni la taille du modèle ni un score obtenu sur un benchmark anglophone ne suffit à garantir le respect de votre vocabulaire métier ou de vos consignes.
DeepSeek local vs API : comment comparer les coûts ?
Comparez le coût total pour obtenir des résultats acceptables, pas uniquement le prix d’un million de tokens. Le calcul doit distinguer une machine déjà disponible, un achat dédié, une location de serveur et une API gérée.
Calculer la consommation de l’API
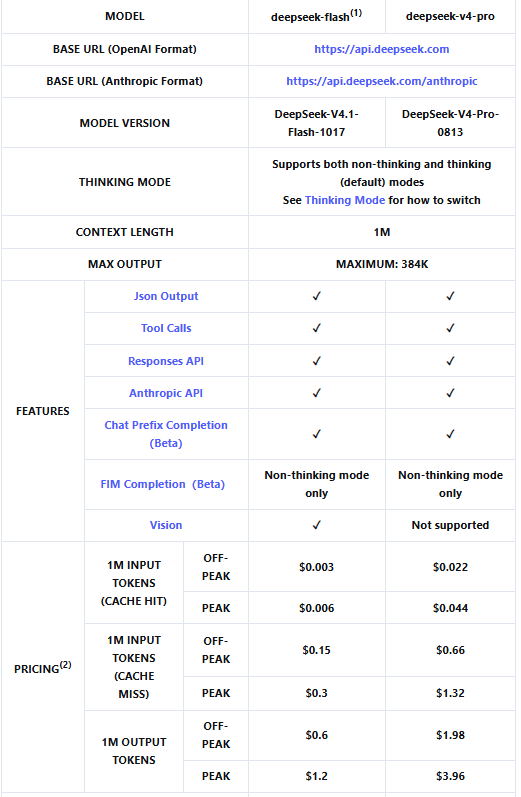
Au 29 octobre 2026, la grille officielle de DeepSeek Flash indique, par million de tokens, 0,15 $ en entrée hors cache et 0,60 $ en sortie en période off-peak, contre 0,30 $ et 1,20 $ en période peak. Les entrées mises en cache possèdent un tarif distinct.
Les périodes peak sont 01 h–04 h et 06 h–10 h UTC, du lundi au vendredi, hors jours fériés chinois. Les autres périodes sont off-peak.
Prenons un scénario de 10 000 demandes, chacune consommant 2 000 tokens d’entrée non cachés et 500 tokens de sortie facturés. Cela représente 20 millions de tokens d’entrée et 5 millions de sortie :
Tout en off-peak : 20 × 0,15 $ + 5 × 0,60 $ = 6 $
Tout en peak     : 20 × 0,30 $ + 5 × 1,20 $ = 12 $
Ce calcul exclut outils et autres frais éventuels. Il ne garantit ni une longueur de réponse réelle ni la réussite des 10 000 tâches. Une consommation répartie entre les périodes doit être ventilée aux tarifs correspondants.
Pour votre budget réel, utilisez les données usage retournées par l’API. La référence Chat Completions distingue les entrées avec et sans cache et détaille les tokens de raisonnement dans les tokens de sortie. Ne comptez pas cette sous-catégorie une seconde fois.
Calculer le coût du local
Pour un achat dédié, répartissez le coût du matériel sur la période d’utilisation retenue, puis ajoutez l’énergie, le stockage, l’exploitation et les protections nécessaires. Pour un serveur loué, utilisez le coût de location plutôt que d’ajouter l’amortissement d’un matériel que vous n’avez pas acheté.
Coût local mensuel =
coût matériel affecté au mois OU location
+ énergie non comprise dans la location
+ stockage et sauvegardes
+ administration et maintenance
+ autres coûts propres au déploiement
Sur une machine déjà disponible, calculez séparément le coût marginal, c’est-à-dire ce que l’usage ajoute réellement, et le coût complet. Un essai peu coûteux sur votre ordinateur ne démontre pas qu’acheter une nouvelle station serait rentable.
Pour l’électricité, multipliez une puissance moyenne mesurée en kW par la durée en heures et le prix local du kWh. Distinguez charge et veille. La puissance maximale annoncée d’un composant ne représente pas automatiquement la consommation moyenne de l’ensemble de la machine.
Incluez aussi les coûts applicatifs des deux options : intégration, validation des réponses, surveillance et traitement des échecs. L’API supprime l’administration du moteur distant, pas tout le travail nécessaire pour exploiter votre produit.
Quand le local devient-il rentable ?
Dans un modèle économique simplifié, avec un coût variable stable par tâche, le point d’équilibre s’écrit :
Nombre de tâches au point d’équilibre =
(coûts fixes locaux − coûts fixes API)
/
(coût variable API par tâche − coût variable local par tâche)
La formule n’est utile que si les résultats comparés sont acceptables et si la capacité locale permet d’atteindre ce volume.
Illustration : reprenons le coût API de 0,0012 $ par demande du scénario peak précédent. Supposons, uniquement pour le calcul, 120 $ de coûts fixes locaux mensuels supplémentaires et 0,0002 $ de coût variable local par tâche. Le point d’équilibre serait de 120 000 tâches par mois.
Ajoutons une hypothèse de capacité : une seule tâche à la fois, 20 secondes par tâche et 100 heures de fonctionnement mensuel. La capacité théorique serait de 18 000 tâches, avant les interruptions. Dans ce scénario, le seuil économique n’est pas atteignable.
Ces hypothèses ne décrivent aucune machine mesurée. Elles montrent pourquoi un seuil calculé ne suffit pas : augmenter la capacité peut nécessiter du matériel supplémentaire et modifier les coûts. Si le coût variable local n’est pas inférieur à celui de l’API, un investissement initial plus élevé ne sera pas automatiquement compensé par le volume.
Enfin, comparez des tâches réussies. Deux modèles peuvent utiliser des tokenizers différents, générer des réponses de longueurs différentes ou nécessiter plusieurs tentatives. Un prix inférieur par token ne garantit pas un coût inférieur par résultat exploitable.
Confidentialité et hors ligne : vérifiez toute la chaîne
Exécuter les poids sur votre infrastructure peut éviter d’envoyer les demandes à un fournisseur d’inférence. Mais cette propriété doit être vérifiée au niveau du workflow complet, pas déduite du seul logiciel installé.
Ollama installé ne signifie pas toujours inférence locale
Ollama prend aussi en charge des modèles hébergés dans son cloud. Sa documentation montre même qu’un appel à l’API locale peut utiliser un modèle distant. Une adresse localhost ne prouve donc pas que l’ensemble du traitement reste sur votre machine.
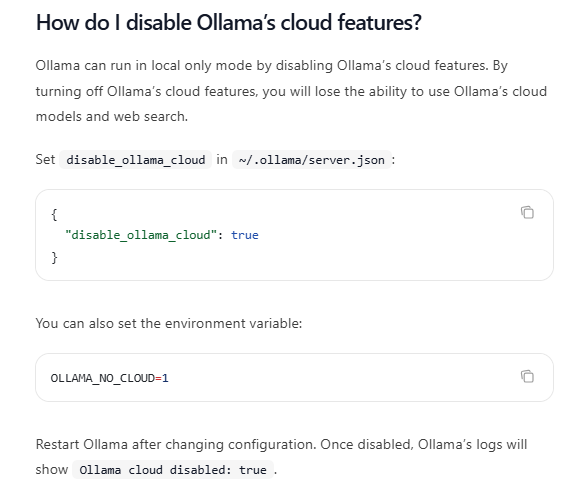
Pour désactiver les fonctions cloud d’Ollama, sa FAQ officielle documente la variable d’environnement suivante :
OLLAMA_NO_CLOUD=1Configurez-la dans l’environnement du processus Ollama, puis redémarrez le service ou l’application. La documentation indique que les journaux doivent alors mentionner Ollama cloud disabled: true. Ce réglage désactive les fonctions cloud d’Ollama, pas les éventuels services externes appelés par votre application.
Une fois un modèle local chargé, utilisez également :
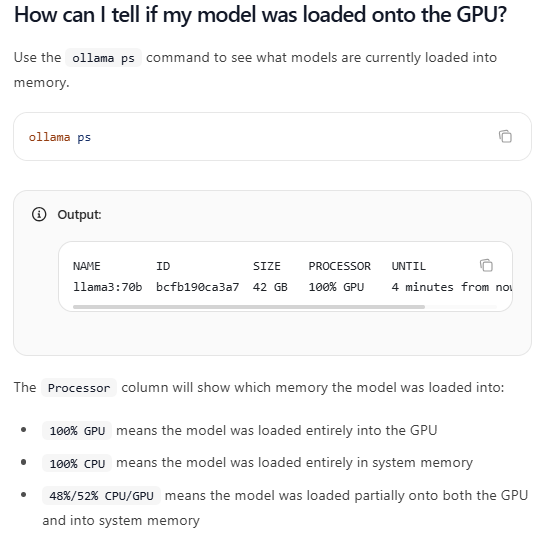
ollama psLa commande permet de consulter les modèles chargés et leur répartition CPU/GPU. Elle aide à vérifier l’exécution, sans constituer un audit complet des connexions réseau.
Fonctionner sans Internet demande une préparation
LM Studio documente un fonctionnement hors ligne pour la conversation, certains traitements documentaires et le serveur local, une fois les fichiers nécessaires disponibles. Le téléchargement initial des modèles et les mises à jour sont des opérations distinctes.
Pour votre workflow, vérifiez aussi les embeddings, l’OCR, la recherche web, les extensions, les journaux et les sauvegardes. Un assistant utilisant un modèle local mais une recherche distante n’est pas entièrement hors ligne. Testez les fonctions nécessaires avec les connexions sortantes contrôlées avant de retenir cette architecture.
Avec l’API, examinez les conditions du service concerné
La politique de confidentialité DeepSeek indique que les données personnelles couvertes par ses services sont collectées, traitées et stockées en République populaire de Chine. Les conditions de l’Open Platform précisent également des responsabilités propres aux développeurs et à leurs applications.
Avant de transmettre des documents sensibles, vérifiez le service utilisé, les catégories de données autorisées, les engagements de conservation et les conditions contractuelles applicables. Un fournisseur tiers peut appliquer d’autres règles. N’inférez pas une absence d’entraînement ou une conservation nulle à partir d’une promesse générale de confidentialité.
La décision ne se résume pas à « local conforme, cloud non conforme ». Pour un usage réglementé, faites examiner les obligations de votre organisation et la configuration précise. L’auto-hébergement ne dispense pas de protéger les accès et de gérer les données conservées.
Fonctionnalités : changer l’URL ne suffit pas toujours
Une intégration dépend du modèle, du moteur et de l’application. Télécharger des poids ne fournit pas automatiquement un moteur de recherche, une gestion des fichiers, un système d’agents ou toutes les fonctions de l’API officielle.
Ollama précise que sa compatibilité OpenAI couvre un sous-ensemble de l’API. Des interfaces proches peuvent donc différer sur l’historique, les paramètres, les outils ou le traitement des réponses.
Avant une migration, vérifiez le nom du modèle, l’authentification, le format des messages, les sorties structurées, le streaming et les appels d’outils. Si votre application utilise des images, confirmez que le checkpoint et le moteur les acceptent réellement : une interface multimodale ne transforme pas un modèle textuel en modèle de vision.
Pour un agent, examinez aussi qui exécute les outils et quelles permissions ils reçoivent. L’auto-hébergement du modèle ne sécurise pas automatiquement les commandes, les fichiers ou les services auxquels l’agent peut accéder.
Exploitation et licences : les responsabilités qui restent
Le local n’est pas sans limites
En auto-hébergement, prévoyez la supervision, les mises à jour, la saturation mémoire, les files d’attente et les pannes. L’absence de quota commercial par requête ne supprime pas la capacité maximale de votre installation.
Avec l’API officielle, DeepSeek applique des limites de concurrence au niveau du compte, indépendamment de la clé utilisée. Une limite de requêtes simultanées n’est pas un quota de requêtes par minute. Votre application doit encore gérer les erreurs, l’attente et les reprises limitées.
Ne supposez pas non plus qu’un serveur local est sécurisé parce qu’un SDK accepte une valeur dans api_key. L’API locale Ollama ne requiert pas d’authentification. LM Studio propose des jetons, mais sa documentation précise que l’authentification doit être activée. Avant d’ouvrir un service sur le réseau, configurez les protections adaptées.
Conservez la version et vérifiez sa licence
Les poids de DeepSeek-V4.1-Flash-1017 sont publiés sous licence MIT. Cela ne permet pas d’attribuer automatiquement la même licence à toutes les générations et variantes.
Le dépôt R1 distingue notamment les origines Qwen et Llama de plusieurs modèles distillés. Pour une redistribution ou une adaptation, examinez le checkpoint exact, sa provenance et les obligations pertinentes.
Conserver un checkpoint précis peut être utile pour suivre les changements de comportement. Enregistrez aussi le moteur, les paramètres et le format de conversation : fixer les poids ne garantit pas, à lui seul, des réponses identiques au caractère près.
Quelle option choisir selon votre projet ?
Pour un prototype sans matériel dédié : commencez par une API si vos données peuvent être transmises dans les conditions du service. Vous pourrez mesurer le besoin avant de financer une infrastructure.
Pour un usage personnel sur une machine déjà adaptée : essayez un modèle local correspondant à vos tâches. Mesurez le délai et la qualité avant d’augmenter la taille du modèle ou le contexte.
Pour des traitements internes à contraintes fortes : étudiez l’auto-hébergement avec un contrôle de toute la chaîne. Prévoyez les compétences d’exploitation nécessaires ; le simple téléchargement des poids ne suffit pas.
Pour un volume élevé et régulier : construisez un calcul de coût complet et vérifiez la capacité soutenable. Pour un trafic irrégulier, évaluez aussi le coût d’une machine qui reste disponible mais peu utilisée.
L’architecture hybride peut-elle être un compromis ?
Une architecture hybride peut affecter certaines tâches au local et d’autres à une API. Par exemple, vous pouvez évaluer un petit modèle local pour une classification interne et réserver un service distant à des analyses autorisées plus complexes.
Les règles de données doivent précéder le routage. Un document interdit de transfert ne doit pas partir automatiquement vers une API parce que le serveur local est occupé. Pour cette catégorie, prévoyez une file d’attente, un refus contrôlé ou une autre capacité interne.
Le mode hybride ajoute aussi du travail : validation des deux sorties, suivi des coûts, cohérence des formats et prévention des basculements non autorisés. Il doit résoudre un besoin identifié, pas simplement multiplier les fournisseurs.
La méthode de décision avant d’acheter du matériel
- Définissez les tâches et les contraintes. Précisez les données autorisées, les fonctions indispensables, le délai acceptable et les critères de réussite.
- Identifiez les configurations exactes. Notez le checkpoint local, sa quantification, le moteur et le modèle API réellement comparé.
- Évaluez un échantillon représentatif. Contrôlez la qualité, les erreurs, la durée et la consommation, en distinguant essais à froid et utilisation habituelle.
- Projetez le coût et la capacité. Intégrez l’exploitation, les pics de demande et les reprises. Vérifiez qu’un éventuel seuil de rentabilité peut être atteint.
Le bon choix pour DeepSeek en local vs API n’est donc pas celui qui promet le plus de contrôle ou le tarif le plus bas sur une seule ligne. C’est celui qui fournit les résultats attendus, dans les délais nécessaires, avec un parcours des données autorisé et un coût total que votre projet peut soutenir.