
DeepSeek ou Qwen : le choix dépend surtout du service et du modèle que vous utiliserez. Pour un assistant proposant des fonctions créatives intégrées, Qwen Studio mérite d’être examiné en priorité. Pour une application utilisant une API, comparez les modèles de même catégorie : DeepSeek Flash n’est pas systématiquement moins cher que Qwen Flash. Pour une installation locale, les deux écosystèmes proposent des possibilités, mais pas avec les mêmes tailles, capacités et licences.
Ce comparatif DeepSeek vs Qwen distingue donc trois décisions : choisir une application de chat, sélectionner un modèle API ou télécharger des poids pour les exécuter sur votre infrastructure. Une fonctionnalité disponible dans un service hébergé n’appartient pas nécessairement au modèle téléchargeable portant un nom voisin.
Vérification documentaire : 29 octobre 2026. Comparaison indépendante fondée sur les sources citées, sans test personnel des deux assistants ni appel payant aux modèles. Les fonctions décrites dans les applications correspondent aux présentations officielles ; leur disponibilité doit être contrôlée dans votre compte.
Quels modèles DeepSeek et Qwen compare-t-on ?
Une comparaison actuelle ne peut pas se limiter à DeepSeek R1 contre Qwen2.5. Ces modèles restent intéressants pour certains déploiements, mais ils ne décrivent pas l’ensemble des offres hébergées disponibles en octobre 2026.
Le journal DeepSeek indique que le chat et l’application officiels utilisent DeepSeek-V4.1-Flash-1017 depuis le 17 octobre 2026. L’API conserve également l’accès à V4 Pro. Chez Qwen, le catalogue Model Studio recommande plusieurs catégories, notamment Qwen3.8-Max, Qwen3.7-Plus et Qwen3.8-Flash.
| Modèle ou identifiant | Périmètre retenu | Intérêt dans la comparaison |
|---|---|---|
deepseek-flash | API directe DeepSeek ; version V4.1-Flash-1017 | Évaluer les traitements courants, les agents et l’analyse d’images |
deepseek-v4-pro | API directe DeepSeek ; version Pro-0813 | Comparer une autre configuration pour les tâches textuelles complexes |
qwen3.8-flash | Offre Qwen hébergée | Comparer une catégorie économique avec DeepSeek Flash |
qwen3.8-max | Offre Qwen hébergée ; version datée lorsque nécessaire | Évaluer les tâches exigeantes avec un modèle positionné haut de gamme |
qwen3.7-plus | Offre Qwen hébergée | Examiner une option intermédiaire plutôt que choisir uniquement entre Flash et Max |
Les noms Flash, Plus et Max désignent des positionnements commerciaux, pas des classes normalisées de performances. Les recommandations QwenCloud orientent vers différents modèles selon le coût, le raisonnement et les outils nécessaires. Elles constituent un point de départ, pas une preuve que chaque tâche exige le modèle le plus cher.
Autre distinction importante : Alibaba Cloud peut servir des modèles DeepSeek en plus des modèles Qwen. Acheter une inférence DeepSeek chez Alibaba ne revient pas à utiliser l’API directe DeepSeek. L’hébergeur, les prix, les limites et les conditions de traitement peuvent changer.
Chat gratuit : lequel choisir pour un usage quotidien ?
Les deux proposent un point d’entrée grand public sans abonnement obligatoire annoncé pour commencer : la page officielle DeepSeek présente son assistant comme gratuit, et la présentation de Qwen Studio annonce également un accès gratuit.
Cette gratuité ne prouve ni l’absence de quotas, ni l’accès permanent à tous les modèles, ni la gratuité des API. Vérifiez les fonctions réellement proposées dans votre session avant d’organiser un travail régulier autour d’elles.
DeepSeek pour les échanges textuels et documentaires
DeepSeek peut constituer un premier choix pour poser des questions, reformuler un texte, demander une explication ou travailler sur du code. La présentation officielle de l’application documente également la recherche Web, l’historique synchronisé et l’importation de fichiers avec extraction de texte.
Ces fonctions doivent être distinguées des spécifications API. Une grande fenêtre de contexte annoncée pour un modèle ne garantit pas que le chat acceptera n’importe quel fichier, ni qu’il interprétera parfaitement tous les tableaux d’un document.
Qwen Studio pour réunir plusieurs outils créatifs
Qwen présente son application avec des fonctions de recherche, de création d’images et de vidéos, ainsi que des contenus HTML et SVG visualisables dans la conversation. Sa présentation explique aussi que des entrées multimodales peuvent être orientées vers un modèle approprié.
Notre recommandation : examinez Qwen Studio en premier si vous recherchez plusieurs outils créatifs dans une même interface. Pour une tâche essentiellement textuelle, commencez par les deux versions accessibles gratuitement et comparez les résultats sur vos propres demandes.
En français, utilisez par exemple le même e-mail à reformuler et le même document à résumer. Évaluez le respect du ton, les omissions, les erreurs et le nombre de corrections nécessaires. Les capacités multilingues annoncées ne suffisent pas à établir qu’un assistant rédige systématiquement mieux que l’autre.
Programmation et raisonnement : que montrent les évaluations ?
Il faut distinguer produire une fonction, corriger un bug et réaliser une tâche complète dans un dépôt. Dans ce dernier cas, le résultat dépend aussi de l’agent, des outils, des permissions, des tests et du budget de calcul.
Les deux écosystèmes documentent le raisonnement et l’utilisation d’outils. DeepSeek propose plusieurs niveaux d’effort dans son Thinking Mode. QwenCloud expose ses propres réglages dans sa documentation du raisonnement. Deux options portant un nom semblable ne correspondent pas nécessairement au même budget.
Pour disposer d’un repère indépendant, les pages Artificial Analysis consultées le 29 octobre 2026 présentent les résultats suivants sur la même version de leur indice composite :
| Modèle évalué | Intelligence Index v5.0 | Source |
|---|---|---|
| DeepSeek V4.1 Flash-1017, mode Max | 32 | Évaluation DeepSeek |
| Qwen3.8 Max, version 0902 | 34 | Évaluation Qwen |
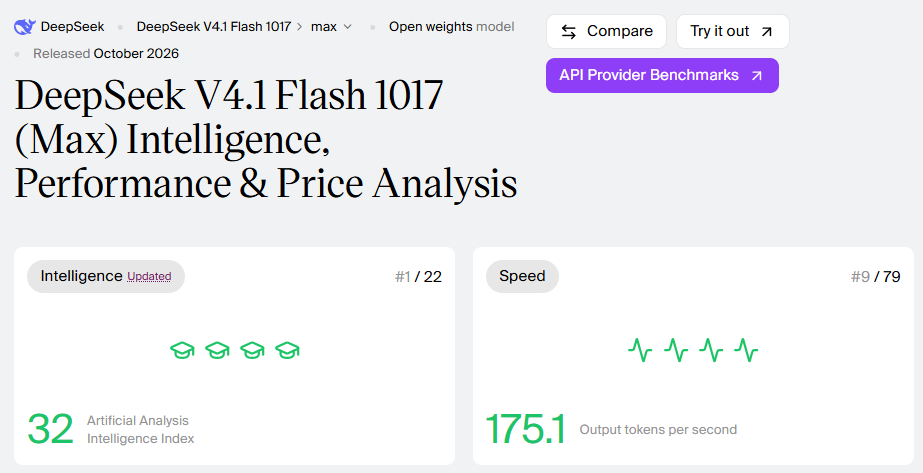
Qwen3.8 Max est légèrement devant sur cet indice précis. Cela ne signifie pas qu’il réussit mieux chaque tâche de programmation, ni que l’écart constitue une différence statistiquement démontrée sur votre usage. Il ne s’agit pas non plus d’une comparaison à budget identique.
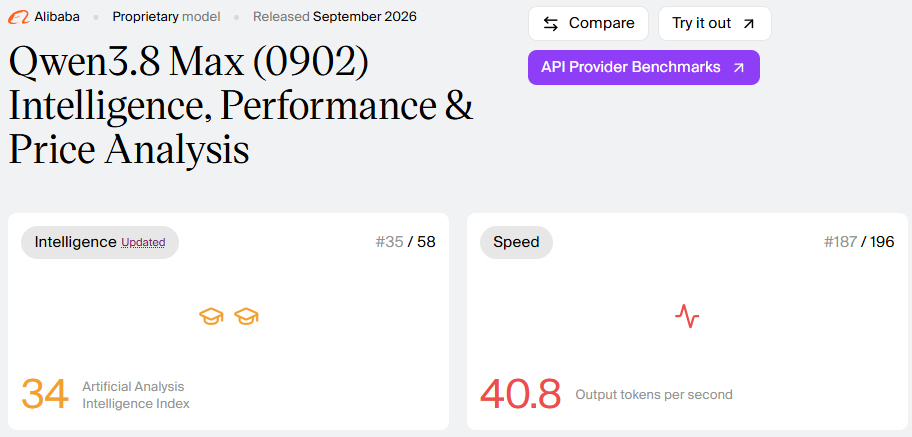
La méthodologie de l’indice agrège plusieurs évaluations. Un score de 34 n’est donc pas un taux universel de 34 % de bonnes réponses. Les anciens scores d’une autre version de l’indice ne doivent pas être comparés directement à ce relevé.
Pour choisir un assistant de développement, testez des demandes vérifiables : corriger une erreur avec des tests existants, ajouter une fonction sans modifier le comportement du reste du projet et expliquer une décision d’architecture. Le critère décisif est le travail accepté après vérification, pas la longueur de la réponse ou du raisonnement.
Images, vidéo et voix : comparez les bonnes capacités
DeepSeek ne se limite plus au texte. Le guide Vision documente les images en entrée pour deepseek-flash, notamment pour décrire une photographie, lire une capture d’écran ou analyser un graphique. Cette prise en charge ne s’étend pas automatiquement à deepseek-v4-pro.
Qwen dispose de plusieurs approches. Le modèle publié Qwen3.8-27B comprend nativement les images et les vidéos. Le catalogue hébergé distingue également des modèles généralistes, des offres Omni et des services spécialisés pour l’image ou l’audio.
La présentation des modèles Model Studio sépare ces catégories. Elle inclut aussi des modèles tiers : toutes les fonctions du catalogue Alibaba ne sont donc pas des capacités propres à Qwen-Max.
Pour votre choix, formulez le besoin précisément. Analyser un graphique, transcrire un enregistrement et générer une image sont trois opérations différentes. Qwen constitue une piste intéressante pour réunir plusieurs modalités, mais il faut identifier les modèles nécessaires et leur facturation. Pour une analyse d’image dans une application existante, DeepSeek Flash reste aussi une option documentée.
Prix API : DeepSeek est-il vraiment moins cher que Qwen ?
Pas dans toutes les catégories. La comparaison doit conserver le fournisseur, la région, le modèle et le mode de facturation. Opposer DeepSeek Flash au seul Qwen Max produirait une conclusion incomplète.
Le tableau ci-dessous utilise l’API directe DeepSeek et les prix standard d’Alibaba Cloud Model Studio pour Singapour, périmètre International. Les montants sont en dollars américains, par million de tokens, hors cache pour l’entrée. Ils ne représentent pas des prix français TTC.
| Modèle et condition | Entrée / 1M | Sortie / 1M | Exemple : 10M en entrée + 2M en sortie |
|---|---|---|---|
| DeepSeek Flash — heures creuses | 0,15 $ | 0,60 $ | 2,70 $ |
| DeepSeek Flash — heures pleines | 0,30 $ | 1,20 $ | 5,40 $ |
| Qwen3.8-Flash — Singapour / International | 0,15 $ | 0,47 $ | 2,44 $ |
| DeepSeek V4 Pro — heures creuses | 0,66 $ | 1,98 $ | 10,56 $ |
| DeepSeek V4 Pro — heures pleines | 1,32 $ | 3,96 $ | 21,12 $ |
| Qwen3.8-Max — Singapour / International | 2,00 $ | 6,00 $ | 32,00 $ |
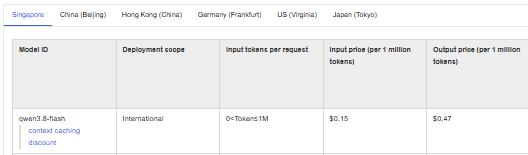
Sources vérifiées le 29 octobre 2026 : tarification DeepSeek et tarification Alibaba Cloud Model Studio. Le scénario est un calcul à volume fixé, sans remise, cache, outil supplémentaire, reprise ni coût d’hébergement.
Pour DeepSeek, les heures pleines correspondent à 01:00–04:00 et 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Les autres périodes sont hors pointe. Chez Qwen, les prix peuvent changer selon la région et le périmètre de déploiement ; ne substituez pas un tarif Global ou de Chine continentale au tarif International sans le signaler.
Ce que l’exemple permet de conclure
Dans ce scénario sans cache, Qwen3.8-Flash coûte moins cher que DeepSeek Flash, tandis que DeepSeek V4 Pro coûte moins cher que Qwen3.8-Max. Cela compare des tarifs et des volumes, pas une qualité équivalente ni un nombre identique de tâches réussies.
Les deux modèles peuvent produire des longueurs différentes, mobiliser davantage de raisonnement ou nécessiter des corrections. Mesurez donc la consommation réellement retournée par chaque service. Ne comptez pas deux fois des tokens de raisonnement déjà inclus dans la sortie facturée.
Le cache et les paliers peuvent modifier le résultat
Le cache de contexte DeepSeek permet de réutiliser certains préfixes déjà traités. Un cache hit dépend de règles de correspondance : ce n’est pas une remise applicable automatiquement à toute l’entrée.
La grille Model Studio prévoit également des mécanismes de cache et, pour certains modèles, des paliers tarifaires. Lorsque ces paliers s’appliquent, la longueur d’entrée détermine la tranche pour la requête ; il ne faut pas supposer un calcul progressif analogue à des tranches fiscales.
Pour une production, comparez plusieurs scénarios : documents courts sans cache, longs préfixes réutilisés et tâches de raisonnement. Un avantage sur un seul de ces scénarios ne démontre pas une économie générale.
Contexte et vitesse : deux critères à lire avec précaution
Les API DeepSeek Flash et Pro annoncent un contexte de 1M de tokens. La documentation QwenCloud annonce également 1M pour Qwen3.8-Max et Flash. Ce chiffre ne signifie pas qu’une réponse peut occuper tout ce volume ni qu’un document sera compris parfaitement.
Le contexte d’un service hébergé n’est pas forcément le contexte natif des poids. Qwen3.8-27B documente, par exemple, 262 144 tokens natifs et une extension possible jusqu’à un million avec une configuration adaptée. Télécharger ce modèle ne configure donc pas automatiquement la limite maximale du service cloud.
Pour la vitesse, séparez le temps avant le premier fragment, le débit de génération et la durée totale jusqu’à une réponse utilisable. Les mesures indépendantes citées plus haut décrivent les configurations testées, pas toutes les instances de ces modèles chez tous les hébergeurs.
QwenCloud propose aussi un mode Prime orienté vers le débit. Il ne faut pas l’interpréter comme une preuve d’intelligence supérieure. Une infrastructure plus rapide et un modèle plus performant sur une tâche sont deux critères différents.
Installation locale : Qwen n’est pas la seule option
Qwen propose des modèles de tailles variées. Le dépôt officiel Qwen3.5-0.8B illustre l’existence de petites variantes ; sa fiche les destine notamment au prototypage et à l’adaptation à des tâches spécifiques. Qwen3.8-27B représente une autre catégorie de capacité et de besoins matériels.
Il serait néanmoins faux d’affirmer que DeepSeek ne possède aucun petit modèle. La fiche officielle R1 répertorie des variantes distillées de 1,5B, 7B, 8B, 14B, 32B et 70B paramètres. Elles ne sont pas les grands modèles V4 actuellement servis par l’API.
Que signifie DeepSeek-R1-Distill-Qwen ?
Les variantes portant ce nom reposent sur des modèles Qwen adaptés à partir d’exemples générés par R1. Elles ne correspondent ni au modèle R1 complet, ni au Qwen de départ inchangé. Leur origine technique ne signifie pas que DeepSeek et Qwen sont la même marque.
La distillation produit un modèle adapté ; la quantification réduit la précision de représentation des poids. Ces deux opérations ne sont pas interchangeables, et leurs effets doivent être évalués sur les tâches visées.
Pour votre machine, examinez les poids, leur précision, la mémoire disponible, le contexte et le moteur d’inférence. Le nombre de paramètres actifs d’un modèle MoE n’équivaut pas à la mémoire totale nécessaire. Ne supposez pas non plus qu’un petit modèle reproduira la qualité du plus grand modèle de sa famille.
Notre conseil : pour expérimenter localement, comparez des variantes compatibles avec votre matériel avant de comparer les modèles phares. Notre guide d’exécution locale de DeepSeek distingue les installations réelles des clients qui envoient les requêtes à un serveur distant.
Poids ouverts et licences : les différences ne se résument pas à MIT contre Apache
Les deux écosystèmes publient des poids, mais les conditions doivent être contrôlées modèle par modèle. Voici quatre exemples vérifiés dans leurs fichiers de licence :
| Checkpoint | Licence publiée |
|---|---|
| DeepSeek-V4.1-Flash-1017 | MIT |
| Qwen3.8-27B | Apache 2.0 |
| Qwen3.8-Flash-Next | Qwen Community License 1.0 |
| Qwen3.8-2.4T-A95B | Qwen3.8-Max License |
Les deux licences Qwen spécifiques comportent notamment des conditions concernant certains usages commerciaux de type service de modèles ou assistant de travail. Leurs critères ne sont pas identiques. Pour une exploitation commerciale, lisez le texte du checkpoint et examinez les obligations applicables à votre activité.
Il est également incorrect d’affirmer que les poids d’un modèle de classe Qwen-Max n’ont jamais été publiés. Le dépôt Qwen3.8-2.4T-A95B existe. Sa fiche précise toutefois que l’offre hébergée Qwen3.8-Max ajoute des fonctions, notamment l’entrée visuelle et le mode non-thinking. Les deux ne sont pas des produits identiques.
Enfin, des poids téléchargeables ne garantissent pas la publication intégrale des données et du processus d’entraînement. Vérifiez séparément la licence, les artefacts disponibles et les conditions d’une éventuelle redistribution.
Confidentialité : comparez le service utilisé, pas seulement son origine
Le traitement des données dépend du destinataire réel : chat grand public, API directe, hébergeur tiers ou installation privée. Deux applications utilisant un même modèle peuvent appliquer des politiques différentes.
Chats grand public : ne présumez pas l’absence de réutilisation
La politique DeepSeek, mise à jour le 10 février 2026, décrit la collecte des contenus transmis et des finalités d’amélioration des modèles. Elle indique également un traitement et un stockage de données personnelles en Chine pour les services relevant de cette politique.
La politique Qwen Studio publiée par Alibaba Cloud (Singapore), datée du 9 avril 2026, décrit elle aussi la collecte des contenus utilisateurs. Elle prévoit l’utilisation de contenus désidentifiés et de retours pour améliorer la qualité des services, y compris les modèles.
Il ne faut donc pas considérer l’un de ces chats comme confidentiel par défaut pour tous les documents. Vérifiez les paramètres, les conditions applicables et les autorisations de votre organisation avant de transmettre un contrat ou des données de clients.
Une API professionnelle peut appliquer d’autres règles
La politique Model Studio actualisée le 27 octobre 2026 décrit, par défaut, une conservation des entrées et sorties jusqu’à 30 jours, sous réserve des exceptions prévues. Les fonctions avec état, comme certains fichiers et conversations, suivent des règles distinctes.
Elle prévoit aussi une option Zero Data Retention pour des clients professionnels éligibles et des modèles compatibles. Cette option doit être activée dans le bon périmètre ; elle ne signifie pas que chaque journal technique, fichier et métadonnée disparaît instantanément. Ces engagements ne doivent pas être attribués automatiquement au chat grand public Qwen.
Un endpoint à Francfort ne garantit pas une inférence limitée à l’Europe
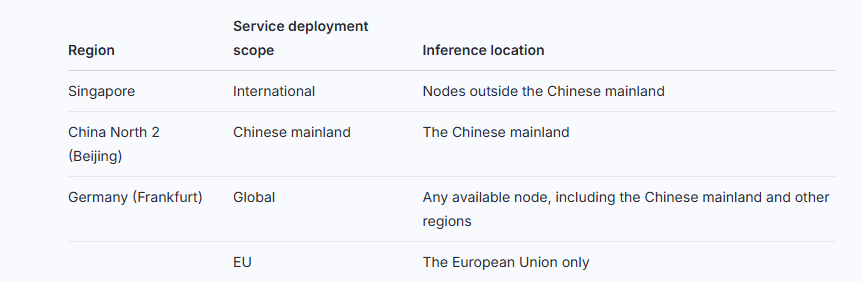
La documentation des régions QwenCloud distingue la région de la ressource et le périmètre d’exécution. À Francfort, un espace Global peut utiliser différents nœuds, y compris en Chine continentale ; un espace EU limite l’inférence à l’Union européenne.
Les deux périmètres ne se déduisent pas du seul nom de l’endpoint. La disponibilité des modèles et les prix peuvent également varier. Pour une exigence européenne, vérifiez l’espace de travail, le périmètre, les modèles autorisés et les engagements contractuels.
Une installation locale offre une autre possibilité de contrôle, à condition d’examiner ses journaux, extensions, télémétries et connexions externes. Aucune de ces architectures ne garantit automatiquement une conformité RGPD. Le dossier sur la sécurité de DeepSeek approfondit les différences entre services hébergés et modèles locaux.
Intégration API : peut-on remplacer l’un par l’autre facilement ?
Les deux proposent des interfaces compatibles avec des formats courants, mais une migration ne se résume pas toujours à remplacer le nom du modèle. La clé, l’endpoint, la région et les paramètres doivent appartenir à l’offre sélectionnée.
DeepSeek documente notamment thinking et reasoning_effort. QwenCloud utilise aussi des réglages comme enable_thinking, thinking_budget et, selon le modèle, reasoning_effort. Les valeurs acceptées et les combinaisons autorisées diffèrent.
Vérifiez également les sorties JSON, les appels de fonctions, les événements de streaming et la conservation du contexte. La présence d’une méthode dans un SDK ne prouve pas que le fournisseur implémente toute la fonction correspondante.
Pour un agent, le modèle propose une opération ; l’application doit contrôler les arguments et les permissions avant de l’exécuter. Pour une application publique, gardez les clés côté serveur, limitez la concurrence et mesurez les coûts. Notre guide API DeepSeek présente le parcours d’intégration directe.
Comment départager DeepSeek et Qwen sur vos propres tâches ?
Voici une méthode de sélection à appliquer avant un abonnement, une intégration ou un déploiement. Elle n’a pas été exécutée comme campagne de tests pour cet article.
- Définissez vos tâches. Choisissez quelques exemples représentatifs et non sensibles : résumé, rédaction française, extraction de données, correction de code ou analyse visuelle.
- Fixez les critères de réussite. Précisez ce qui doit être exact, les contraintes de format et les erreurs qui rendent le résultat inutilisable.
- Identifiez les configurations. Notez le modèle, la version, le fournisseur, les outils, la région et le mode de raisonnement.
- Comparez les résultats vérifiés. Mesurez les corrections nécessaires, la durée totale et les tokens réellement consommés. Répétez les cas dont le résultat varie.
- Décidez au niveau de la tâche. Retenez le service qui satisfait vos critères au coût acceptable, puis prévoyez une nouvelle vérification lorsque le modèle change.
Ne mélangez pas une réponse avec recherche Web et une autre sans sources si vous cherchez à mesurer la fiabilité documentaire. De même, un petit modèle local ne doit pas être jugé comme l’équivalent automatique d’un service haut de gamme distant.
Verdict : quand privilégier DeepSeek ou Qwen ?
Privilégiez l’évaluation de Qwen Studio pour un usage créatif multimodal, de Qwen3.8-Flash pour les scénarios API où son tarif est avantageux, et des variantes Qwen adaptées à votre matériel pour le local. Ces trois recommandations concernent des produits différents : elles ne signifient pas qu’un seul modèle Qwen réunit tous les avantages.
Évaluez DeepSeek Chat pour un usage conversationnel gratuit et DeepSeek Flash ou Pro lorsque leurs résultats, leur intégration et leurs conditions d’exploitation correspondent à votre projet. La licence MIT de certains checkpoints peut être un critère important, mais elle ne remplace ni une mesure de qualité ni une étude du coût d’hébergement.
Pour des données sensibles, le choix de l’hébergeur et du périmètre de traitement peut être plus déterminant que le classement du modèle. Pour les autres usages, retenez une configuration précise qui réussit vos tâches : le bon choix n’est pas « une marque gagne partout », mais un modèle fiable dans vos contraintes.