
DeepSeek V4.1 Flash est un modèle d’intelligence artificielle multimodal capable de traiter du texte et des images pour produire des réponses textuelles. Annoncé officiellement le 10 septembre 2026, il associe raisonnement, programmation et utilisation d’outils à une architecture conçue pour réduire le coût de traitement des longs contextes, selon son annonce de lancement.
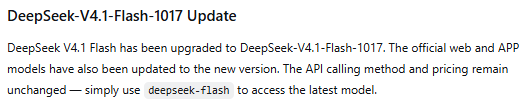
Le modèle a ensuite reçu une mise à jour nommée DeepSeek-V4.1-Flash-1017. Pour l’utiliser dans l’API officielle au 29 octobre 2026, l’identifiant à transmettre est deepseek-flash, et non le nom complet de son dépôt de poids. La documentation de démarrage précise cette correspondance.
L’enjeu n’est donc pas seulement de savoir si Flash est « puissant » : il faut identifier la version utilisée, les fonctions de votre interface et le coût du workflow complet. Voici les points à connaître pour choisir entre le chat, l’API et les poids téléchargeables.
Vérification éditoriale : 29 octobre 2026.
DeepSeek V4.1 Flash et Flash-1017 : quelle version utilisez-vous ?
Le nom V4.1 Flash désigne la génération lancée en septembre. Le suffixe 1017 identifie sa mise à jour du 17 octobre. DeepSeek l’a déployée sur son site, dans son application et dans son API, comme l’indique le journal officiel des versions.
| Référence | Ce qu’elle désigne | Conséquence pratique |
|---|---|---|
| DeepSeek V4.1 Flash | La génération annoncée le 10 septembre 2026. | Un article de septembre peut décrire le modèle avant son amélioration d’octobre. |
| DeepSeek-V4.1-Flash-1017 | Le checkpoint publié lors de la mise à jour du 17 octobre. | Utilisez ce nom pour identifier les poids et les évaluations de cette version. |
deepseek-flash | L’identifiant accepté par l’API officielle. | Il donne accès à Flash-1017 à la date de vérification. |
deepseek-v4-flash et deepseek-v4-flash-vision-exp | D’anciens noms encore acceptés pour compatibilité. | Ils ne garantissent plus l’exécution des modèles historiques correspondants. |
La documentation API indique que ces anciens noms Flash sont redirigés vers V4.1-Flash-1017. Pour une nouvelle intégration, utilisez l’identifiant documenté deepseek-flash.
Pour reproduire une expérience, conservez la date, le fournisseur, l’identifiant demandé et les paramètres. Un alias de service hébergé peut évoluer : il ne constitue pas, à lui seul, une garantie de conserver indéfiniment les mêmes poids.
Qu’apporte la mise à jour 1017 ?
Dans son annonce du 17 octobre 2026, DeepSeek présente des améliorations en raisonnement, programmation, tâches agentiques et compréhension visuelle. L’entreprise annonce également des tâches terminées plus rapidement avec des sorties plus courtes. Il s’agit de résultats et d’observations du développeur, pas de garanties applicables à chaque requête.
La fiche officielle de Flash-1017 permet de comparer quelques scores avec ceux du checkpoint de septembre :
| Évaluation | V4.1 Flash de septembre | Flash-1017 |
|---|---|---|
| HLE, sans outils | 36,8 | 42,6 |
| Terminal-Bench 4.0 | 31,2 | 42,3 |
| DeepSWE v1.1 | 74,2 | 77,0 |
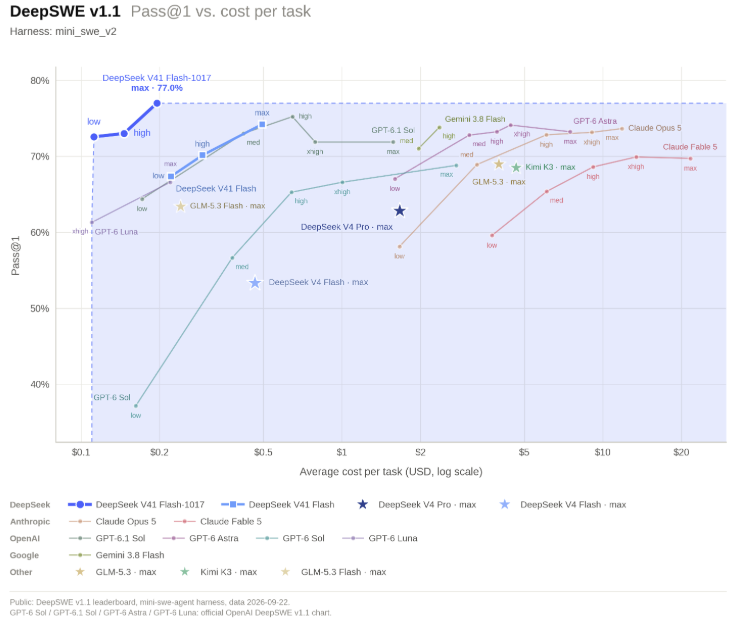
Ces scores sont ceux publiés par DeepSeek. La fiche précise l’utilisation de Claude Code pour Terminal-Bench 4.0 et de Mini-SWE-V2 pour DeepSWE v1.1. Elle distingue aussi le résultat HLE global sans outils de son sous-ensemble textuel, évalué à 44,0 pour 1017.
Ces différences de protocole comptent. Un résultat Terminal-Bench 2.1 ne se compare pas directement à Terminal-Bench 4.0, et une performance obtenue avec un agent dépend aussi de ses outils et de sa configuration. Pour votre application, mesurez surtout la proportion de tâches correctement terminées, les erreurs restantes et le temps nécessaire à leur vérification.
Le changelog indique que la méthode d’appel et les prix n’ont pas changé lors du passage à 1017. Une diminution du nombre de jetons générés peut réduire le coût d’une tâche, mais elle ne signifie pas qu’une nouvelle baisse du tarif unitaire a été appliquée.
Vision, programmation et contexte long : quelles capacités concrètes ?
Comprendre des images, sans les confondre avec des images générées
Le guide Vision décrit l’envoi de texte et d’images à deepseek-flash, notamment pour expliquer une capture d’écran, lire du texte visible ou analyser un graphique. Les formats documentés comprennent JPEG, PNG, GIF et WebP.
Cette vision native ne désigne pas un générateur d’images. Le modèle est présenté comme recevant du texte et des images pour produire du texte. La création d’un visuel, d’une vidéo ou d’une scène 3D par un environnement agentique peut mobiliser du code et des outils supplémentaires.
Pour essayer cette capacité, fournissez un graphique non confidentiel et demandez : « Identifie les axes, les unités et la tendance principale. Signale les valeurs illisibles et ne déduis pas de causalité à partir de la seule courbe. » Vérifiez ensuite les valeurs dans le document d’origine. Il s’agit d’une consigne illustrative, non d’un test exécuté ici.
Un contexte de 1M de jetons, mais un budget à gérer
Le catalogue API officiel annonce un contexte de 1M de jetons et une sortie maximale de 384K. La référence Chat Completions précise que le total des jetons d’entrée et des jetons générés reste limité par la fenêtre de contexte.
Vous ne devez donc pas additionner librement une entrée maximale et une sortie maximale. La limite de sortie n’est pas non plus la valeur utilisée par défaut : la référence indique 8K sans Thinking, 64K avec Thinking et 128K lorsque l’effort est réglé sur max, en l’absence de valeur explicite.
Pour traiter un dossier long, sélectionnez les documents pertinents et demandez des références aux passages utilisés. Une grande fenêtre permet de fournir davantage de contexte ; elle ne remplace pas la vérification que les éléments décisifs ont été correctement exploités.
Code, outils et données structurées
Flash peut être intégré à une application qui lui expose des fonctions. La documentation Tool Calls distingue la demande produite par le modèle de l’exécution réelle d’une fonction personnalisée, qui reste du ressort du programme.
Pour un assistant de développement, cela signifie que lire un dépôt, modifier un fichier ou lancer des tests nécessite un outil et des permissions appropriés. Un score de programmation ne donne pas automatiquement au modèle un accès à votre ordinateur.
Pour l’extraction de données, JSON Output permet de demander une sortie JSON dans Chat Completions. La Responses API documente également des formats structurés. Dans les deux cas, contrôlez la réponse et les valeurs avant de les enregistrer ou de déclencher une opération métier.
Quel est le prix de DeepSeek V4.1 Flash ?
Voici les tarifs de l’API officielle affichés le 29 octobre 2026. Ils sont exprimés en dollars américains par million de jetons, selon la grille DeepSeek.
| Jetons facturés | Heures creuses | Heures de pointe |
|---|---|---|
| Entrée avec cache utilisé | 0,003 $ | 0,006 $ |
| Entrée sans cache utilisé | 0,15 $ | 0,30 $ |
| Sortie | 0,60 $ | 1,20 $ |
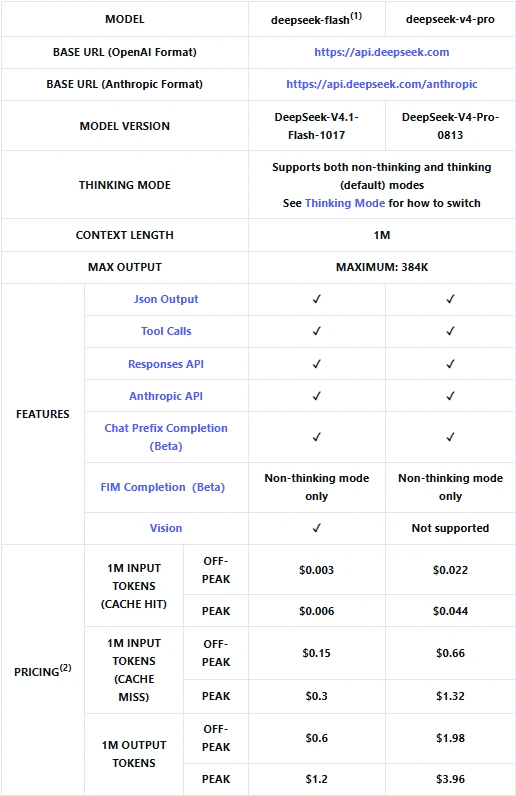
Les périodes de pointe documentées sont 01:00–04:00 et 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Les autres périodes relèvent du tarif heures creuses. Les horaires sont conservés en UTC pour éviter une conversion française incorrecte lors des changements d’heure.
Le tarif d’entrée le plus bas ne concerne pas tous les appels. Le cache de contexte dépend de la réutilisation de préfixes effectivement disponibles. Utilisez les compteurs de consommation renvoyés par l’API plutôt qu’une hypothèse de cache systématique.
Exemple de budget, avec hypothèses explicites
Supposons 1 000 requêtes fictives, consommant chacune 2 000 jetons d’entrée non mis en cache et 500 jetons de sortie facturés. Cela représente deux millions de jetons d’entrée et un demi-million de jetons de sortie.
Avec les tarifs ci-dessus, le calcul donne 0,60 $ en heures creuses : 2 × 0,15 + 0,5 × 0,60. Le même volume atteint 1,20 $ en heures de pointe. Cet exemple exclut les outils externes, les nouvelles tentatives, les autres services et les éventuels frais d’intermédiaires.
Le volume réel doit inclure tous les jetons facturés, pas seulement le texte visible. La référence Responses API distingue notamment les jetons de raisonnement dans le détail de la sortie.
Recherche et outils peuvent ajouter des frais
Les interfaces Search et Fetch sont facturées séparément selon leurs règles de service. L’annonce du 17 octobre prévoit aussi la fin d’un accès temporairement gratuit pour certains appels côté serveur via des agents, à partir du 1er novembre 2026 à 00:00, heure de Pékin.
Pour un agent, comparez donc le coût d’une tâche terminée : appels au modèle, recherches, résultats retransmis, éventuelles corrections et validation humaine. Un prix unitaire faible ne suffit pas à établir la rentabilité du système.
Comment utiliser DeepSeek V4.1 Flash ?
Dans le chat et l’application officiels
Pour une utilisation sans programmation, passez par le chat officiel ou les liens de téléchargement du site DeepSeek. L’annonce de Flash-1017 confirme son déploiement sur le Web et dans l’application.
La fiche française de l’application officielle la présente comme gratuite. Cela ne signifie ni que chaque fonction dispose d’un quota illimité, ni que les appels API sont inclus.
Commencez par une tâche dont vous pouvez contrôler la réponse : expliquer une fonction courte, comparer deux extraits autorisés ou commenter un graphique. Les interfaces après connexion n’ont pas été inspectées pour cet article ; aucun emplacement précis de bouton ou sélecteur de modèle n’est donc supposé.
Depuis un fournisseur tiers
Un fournisseur peut héberger les mêmes poids tout en appliquant son propre identifiant, ses limites et ses conditions. Par exemple, Mistral documente depuis le 28 octobre 2026 une offre Flash-1017 en préversion publique, présentée comme textuelle, avec l’identifiant deepseek-v4-1-flash-1017 et une sortie maximale de 128K.
Ces conditions ne doivent pas être remplacées par celles de l’API DeepSeek officielle. Avant une migration, vérifiez les modalités acceptées, les paramètres, les prix, la conservation des données et la version effectivement servie.
Appeler Flash-1017 avec l’API : exemple Python
Le programme suivant utilise l’endpoint officiel Chat Completions avec deepseek-flash. Il choisit explicitement le mode sans raisonnement pour une demande courte, limite la sortie et refuse une réponse vide ou interrompue.
Installez Requests avec python -m pip install requests. Configurez ensuite votre clé dans la variable d’environnement DEEPSEEK_API_KEY, sans l’écrire dans le fichier ou dans un dépôt public.
import os
import requests


def interroger_flash(question: str) -> str:
    cle = os.environ.get("DEEPSEEK_API_KEY", "").strip()
    if not cle:
        raise RuntimeError("Variable DEEPSEEK_API_KEY manquante.")
    if not isinstance(question, str) or not question.strip():
        raise ValueError("La question doit être un texte non vide.")

    try:
        reponse = requests.post(
            "https://api.deepseek.com/chat/completions",
            headers={"Authorization": f"Bearer {cle}"},
            json={
                "model": "deepseek-flash",
                "messages": [{"role": "user", "content": question}],
                "thinking": {"type": "disabled"},
                "max_tokens": 600,
                "stream": False,
            },
            timeout=(5, 60),
        )
    except requests.RequestException:
        raise RuntimeError("Échec réseau ou délai dépassé.") from None

    if reponse.status_code != 200:
        raise RuntimeError(f"Erreur API HTTP {reponse.status_code}.")
    try:
        corps = reponse.json()
    except ValueError:
        raise RuntimeError("Réponse HTTP non JSON.") from None

    choix = corps.get("choices") if isinstance(corps, dict) else None
    if not isinstance(choix, list) or not choix or not isinstance(choix[0], dict):
        raise RuntimeError("Structure de réponse inattendue.")
    premier = choix[0]
    if premier.get("finish_reason") != "stop":
        raise RuntimeError("Génération non terminée normalement.")
    message = premier.get("message")
    texte = message.get("content") if isinstance(message, dict) else None
    if not isinstance(texte, str) or not texte.strip():
        raise RuntimeError("Réponse finale vide.")
    return texte


if __name__ == "__main__":
    try:
        print(interroger_flash(
            "Explique en français la différence entre un test unitaire "
            "et un test d’intégration, avec un exemple de chaque."
        ))
    except (RuntimeError, ValueError) as erreur:
        raise SystemExit(str(erreur)) from None
La requête suit le format décrit dans la documentation de démarrage DeepSeek. Les délais de connexion et de lecture sont des réglages du client, pas une garantie de durée globale.
Vérification du programme : la syntaxe et neuf tests locaux avec réponses simulées ont été validés, notamment pour les erreurs HTTP, les interruptions réseau et les contenus incomplets. Aucun appel réel ou payant à DeepSeek n’a été effectué. Ces tests vérifient le traitement des réponses, pas les performances du modèle.
Comment régler le mode Thinking ?
Le guide Thinking Mode indique un raisonnement activé par défaut avec l’effort high. En Chat Completions, thinking permet de l’activer ou de le désactiver, tandis que reasoning_effort propose notamment low, high et max.
Pour une classification simple ou une explication courte, comparez un réglage léger avec le mode sans raisonnement. Pour une tâche difficile, évaluez un effort supérieur sur des exemples représentatifs. Le bon réglage est celui qui améliore suffisamment le résultat pour justifier son délai et sa consommation.
Les paramètres d’échantillonnage ne sont pas tous actifs dans chaque mode : la documentation précise notamment que temperature n’a pas d’effet en Thinking. Ne copiez pas automatiquement les recommandations d’un checkpoint local dans une requête hébergée.
Conservez uniquement la réponse finale pour l’affichage utilisateur. Si vous développez une boucle d’outils, vérifiez séparément les règles de retransmission de reasoning_content dans l’historique requis par l’API.
552B, 763B, 8B ou 16B : comprendre les chiffres
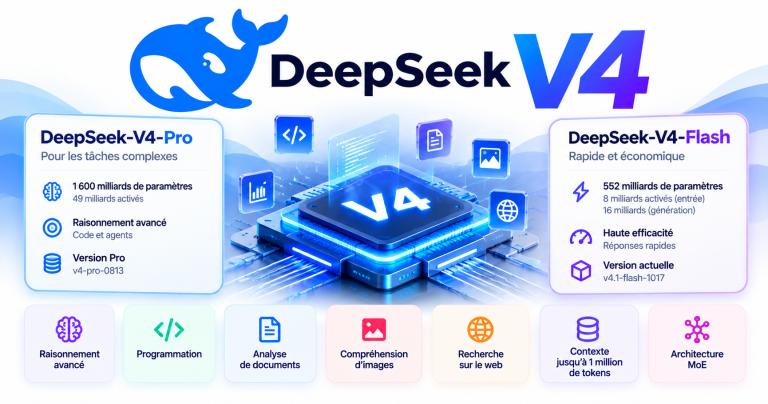
Le rapport technique DeepSeek-V4.1-Flash décrit une architecture Mixture-of-Experts comprenant 552 milliards de paramètres dans le réseau principal. Il distingue aussi une mémoire conditionnelle Engram de 196 milliards de paramètres.
Le traitement est asymétrique : environ 8 milliards de paramètres sont activés pendant le préremplissage, qui traite l’entrée, et 16 milliards pendant le décodage, qui produit la réponse. L’architecture Causal Encoder–Decoder sépare ces phases.
La fiche du modèle sur Hugging Face affiche par ailleurs 763B dans les métadonnées de taille des poids. Ce chiffre ne porte pas le même libellé que les paramètres du réseau principal ou les paramètres actifs. Il ne faut pas substituer l’un à l’autre ni inventer une décomposition complète des fichiers à partir de ces seuls nombres.
Pourquoi compresser le cache KV ?
Le cache KV conserve des informations intermédiaires utilisées pendant l’inférence. Le rapport associe Compressed Sparse Attention 2, réutilisation entre couches et stockage à faible précision pour réduire son empreinte. Il annonce environ un quart de l’espace du cache global de V4 Flash et un huitième pour le cache persistant, dans son dispositif.
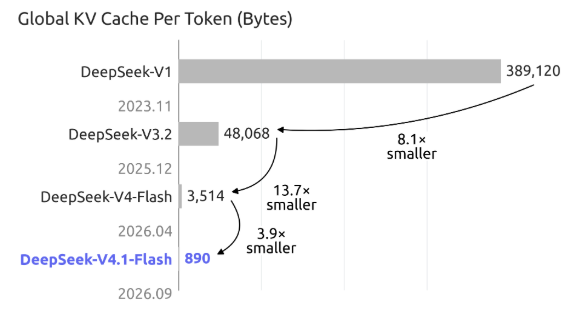
Ces gains concernent le cache, pas une division équivalente de tous les poids ou de toute facture. La compression interne du cache et une remise API pour un préfixe réutilisé sont deux mécanismes différents.
DeepSeek V4.1 Flash ou V4 Pro : lequel choisir ?
V4 Pro n’a pas été simplement supprimé comme l’annonçait le plan initial. L’annonce de septembre prévoyait une redirection vers Flash, mais le changelog mis à jour précise le maintien du service V4 Pro après le 14 septembre 2026. Le catalogue continue de distinguer Flash-1017 et V4-Pro-0813.
Pour une nouvelle application, Flash mérite une première évaluation lorsque vous souhaitez combiner vision et traitement textuel avec les tarifs présentés plus haut. Cela ne démontre pas qu’il gagnera sur chaque tâche, pas plus que le nom « Pro » ne prouve automatiquement une qualité supérieure.
La compatibilité des outils peut aussi décider du choix. Le guide Responses API indique actuellement que l’outil intégré web_search fonctionne avec deepseek-v4-pro, mais est ignoré avec deepseek-flash. Une application Flash peut utiliser des résultats récupérés séparément, mais ce n’est pas la même configuration.
Comparez les deux modèles sur vos propres tâches, avec des entrées, des outils et des critères cohérents. Mesurez la réponse correcte, les corrections nécessaires, le délai total et le coût final. Conserver Pro peut rester pertinent si votre workflow validé dépend de son comportement ou de ses fonctions spécifiques.
Téléchargement, licence et exécution locale
DeepSeek publie des dépôts distincts pour V4.1 Flash de septembre et Flash-1017. Pour travailler avec un checkpoint identifiable, sélectionnez le dépôt correspondant et conservez sa révision.
Le dépôt 1017 et ses poids sont annoncés sous licence MIT. Celle-ci autorise notamment l’usage, la modification et la redistribution selon ses conditions, dont la conservation des mentions requises. Cette licence ne signifie pas que toutes les données et étapes d’entraînement sont reproductibles à partir du dépôt.
« Flash » ne signifie pas « petit modèle pour ordinateur portable »
Le répertoire de fichiers 1017 affiche environ 510 Go à la date de vérification. Il s’agit d’une taille de dépôt, non d’un minimum de RAM ou de VRAM.
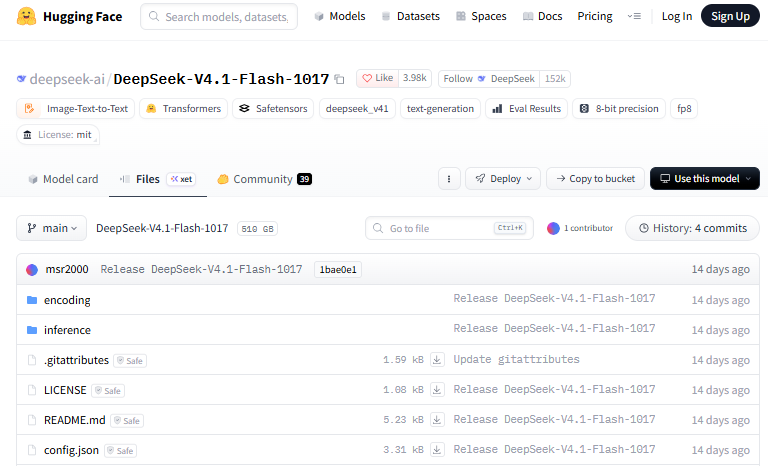
Les besoins dépendent du format des poids, du moteur d’inférence, de la longueur de contexte, de la répartition du modèle et des traitements simultanés. Les paramètres actifs ne suffisent pas à dimensionner la mémoire nécessaire.
Le guide d’inférence officiel fournit une implémentation de référence et des étapes de conversion des poids. Il précise qu’il ne s’agit pas d’un moteur de service optimisé pour la production. Un exemple de parallélisme donné dans ce guide ne constitue pas une configuration minimale universelle.
Avant un achat de matériel, validez la compatibilité du runtime avec ce checkpoint exact et mesurez une configuration comparable. Une conversion communautaire ou une commande générique proposée par une plateforme ne prouve pas que le modèle complet fonctionne confortablement sur votre machine.
Quelles précautions prendre avant un usage professionnel ?
Évaluez le modèle avec des cas représentatifs, pas uniquement avec une démonstration réussie. Pour du code, vérifiez les modifications et exécutez les tests. Pour une image, comparez les valeurs reconnues à l’original. Pour une extraction, contrôlez les champs et la cohérence métier.
Lorsqu’un agent peut agir, limitez ses permissions et faites confirmer les opérations sensibles. Les recommandations OWASP sur l’autonomie excessive des agents soulignent les risques liés à des outils trop puissants, à des autorisations trop larges et à l’absence de supervision.
La confidentialité dépend également du déploiement. La politique DeepSeek mise à jour le 10 février 2026 décrit la collecte de contenus fournis aux services concernés et le traitement de données personnelles en République populaire de Chine. Elle distingue ces services des applications développées par des tiers, qui doivent présenter leurs propres règles.
N’étendez pas cette politique automatiquement à un hébergeur indépendant ou à une infrastructure privée. Inversement, des poids sous licence MIT ou une installation locale ne constituent pas une garantie de confidentialité : examinez aussi les journaux, plugins, accès réseau et outils connectés.
Pour une organisation française, faites vérifier les contrats et les flux correspondant aux données réellement traitées. Évitez de transmettre des secrets, du code confidentiel ou des documents personnels sans autorisation appropriée.
Faut-il choisir DeepSeek V4.1 Flash ?
Pour découvrir le modèle, commencez par le service officiel avec une tâche vérifiable. Pour construire une application, testez deepseek-flash avec un budget explicite et les fonctions effectivement compatibles. Pour la recherche ou l’auto-hébergement, choisissez les poids 1017 lorsque c’est cette version que vous souhaitez reproduire.
Le critère décisif reste le résultat utile : une tâche correctement accomplie, à un coût acceptable, dans un environnement maîtrisé. Les benchmarks, la grande fenêtre de contexte et les tarifs donnent des raisons d’évaluer Flash ; ils ne remplacent pas cette validation sur vos usages.