
DeepSeek V4 Pro est le modèle de la famille V4 destiné notamment au raisonnement, à la programmation et aux applications utilisant des outils. Au 29 octobre 2026, l’API officielle documente toujours l’identifiant deepseek-v4-pro, associé à DeepSeek-V4-Pro-0813. Il ne faut le confondre ni avec la préversion d’avril, ni avec le modèle Flash utilisé dans le chat officiel.
Pour choisir Pro, la question n’est pas seulement de connaître sa taille : son coût supplémentaire doit être justifié par de meilleurs résultats sur vos tâches. Ce guide examine sa disponibilité, ses caractéristiques, les évaluations publiées, les tarifs et les méthodes d’accès, sans supposer que le nom « Pro » garantit une supériorité sur Flash.
Vérification documentaire : 29 octobre 2026.
DeepSeek V4 Pro est-il toujours disponible ?
Oui, V4 Pro reste proposé dans l’API officielle. Le journal des mises à jour DeepSeek précise que le service a été maintenu après le 14 septembre 2026, à la suite de demandes d’utilisateurs.
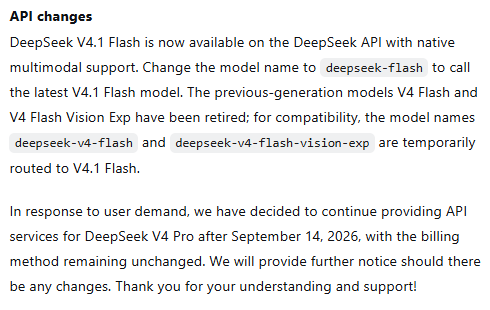
La confusion vient de l’annonce initiale de V4.1 Flash, qui prévoyait une redirection des requêtes Pro vers Flash. Cette intention ne décrit plus le statut confirmé par le journal ultérieur et par la grille actuelle des modèles.
Trois noms doivent être distingués. DeepSeek-V4-Pro Preview correspond au lancement du 24 avril 2026. DeepSeek-V4-Pro-0813 est la version officielle publiée le 13 août 2026. Enfin, deepseek-v4-pro est l’identifiant à utiliser pour appeler le modèle documenté par l’API.
Le chat et l’application ont, de leur côté, été actualisés vers V4.1 Flash-1017 le 17 octobre 2026. Les anciennes instructions invitant à sélectionner « Expert Mode » ne suffisent donc pas à garantir un accès actuel à Pro dans une interface grand public. Pour cibler Pro explicitement, utilisez une offre qui identifie clairement le modèle servi.
Fiche technique : ce qu’il faut savoir sur Pro-0813
Les caractéristiques suivantes décrivent le modèle Pro et les capacités publiées pour son API. Elles ne doivent pas être étendues automatiquement à une offre tierce.
| Caractéristique | DeepSeek V4 Pro |
|---|---|
| Version API documentée | DeepSeek-V4-Pro-0813 |
| Identifiant | deepseek-v4-pro |
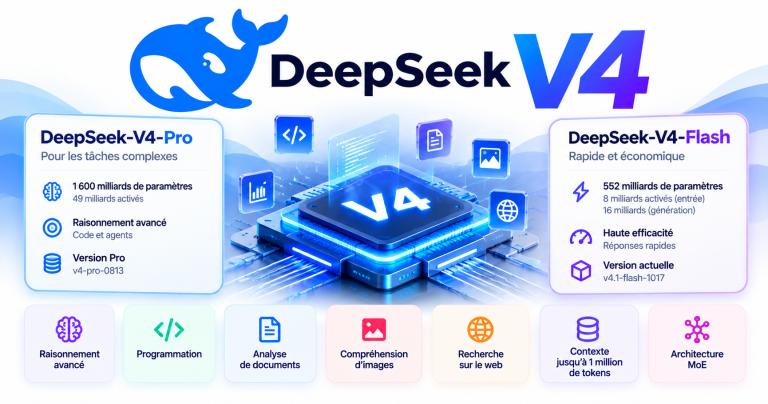
| Architecture principale | Mixture of Experts, ou MoE |
| Paramètres annoncés pour la structure Pro | 1 600 milliards au total ; 49 milliards activés par token |
| Contexte annoncé | 1M de tokens |
| Sortie maximale en Chat Completions | 384K, soit 393 216 tokens dans la référence API |
| Modalités de l’API Pro | Texte en entrée et en sortie ; Vision non prise en charge |
| Raisonnement | Modes thinking et non-thinking ; efforts low, high et max |
| Fonctions d’intégration | Chat Completions, Responses, format Anthropic, JSON Output et appels d’outils |
| Distribution des poids Pro-0813 | Dépôt officiel Hugging Face, sous licence MIT |
Sources : architecture Pro d’origine, modèles et fonctionnalités API, référence Chat Completions et licence du checkpoint Pro-0813.
Un contexte de 1M n’est pas une réponse de 1M de tokens
La fenêtre de contexte encadre les informations que le modèle peut traiter. La référence API indique que l’entrée et les tokens générés doivent respecter ensemble cette limite. La sortie possède son propre plafond, défini par max_tokens.
Sans réglage explicite, DeepSeek documente 8K de sortie en mode non-thinking, 64K en thinking et 128K lorsque l’effort est réglé sur max. Ces plafonds ne sont pas des longueurs promises ni des volumes facturés d’office. Une génération peut s’arrêter plus tôt ou être interrompue à sa limite.
Pour analyser un document long, sélectionnez les passages utiles et exigez des repères vérifiables. Une grande fenêtre ne garantit ni une lecture parfaite de chaque détail, ni l’acceptation directe d’un PDF ou d’un classeur.
Quel est le prix de DeepSeek V4 Pro ?
La grille officielle consultée le 29 octobre 2026 distingue l’entrée en cache, l’entrée hors cache et la sortie. Voici les tarifs de Pro en dollars américains, par million de tokens :
| Poste facturé | Heures creuses | Heures pleines |
|---|---|---|
| Entrée en cache | 0,022 $ | 0,044 $ |
| Entrée hors cache | 0,66 $ | 1,32 $ |
| Sortie | 1,98 $ | 3,96 $ |
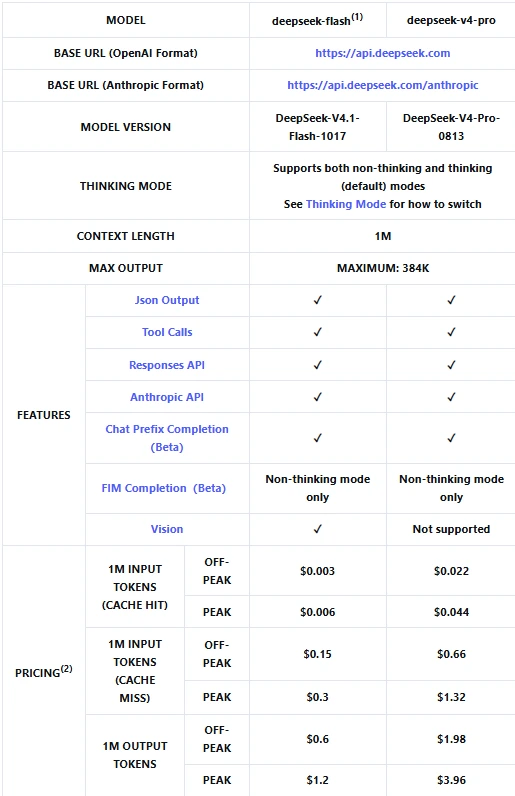
Les heures pleines couvrent 01:00–04:00 et 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Les autres périodes sont hors pointe. Ne transposez pas ces horaires en heure française sans tenir compte du changement d’heure.
Exemple : 10 millions de tokens en entrée et 2 millions en sortie
Prenons un traitement fictif totalisant 10 millions de tokens d’entrée hors cache et 2 millions de tokens de sortie facturables. Avec les tarifs ci-dessus, le calcul hors pointe est :
(10 × 0,66 $) + (2 × 1,98 $) = 10,56 $Le même volume coûterait 21,12 $ en heures pleines. Pour Flash, les tarifs publiés conduisent à 2,70 $ hors pointe et 5,40 $ en pointe avec ces mêmes hypothèses. Il s’agit d’une comparaison arithmétique à volume fixé, pas d’une mesure du coût de réalisation d’une tâche identique.
Les sorties facturables doivent inclure les tokens de raisonnement selon les statistiques d’usage du protocole ; ne les ajoutez pas une seconde fois à un total qui les comprend déjà. L’exemple exclut l’hébergement, les outils supplémentaires, les reprises et les taxes.
Le cache de contexte peut réduire le coût de préfixes réutilisés. Il ne faut cependant pas supposer que toute l’entrée bénéficiera automatiquement du tarif en cache. Mesurez les catégories de tokens effectivement retournées par l’API.
Pour un budget, comparez le coût par tâche réussie : une réponse moins chère mais inutilisable peut nécessiter plusieurs essais. À l’inverse, un modèle plus coûteux n’apporte pas nécessairement de gain pour une extraction simple. Notre guide des prix DeepSeek détaille la facturation.
DeepSeek V4 Pro ou Flash : les différences qui comptent
Le Flash à examiner en octobre 2026 est V4.1 Flash-1017, pas seulement le Flash Preview lancé avec Pro en avril. Une comparaison reprenant uniquement les premiers résultats de V4 risque donc de répondre à une ancienne situation.
Pour les images, la distinction est nette : le guide Vision cible deepseek-flash. L’API Pro n’offre pas cette entrée native. Pro peut analyser du texte extrait ailleurs, mais cela ne revient pas à interpréter lui-même la photographie ou le graphique original.
Une autre différence peut compter pour certains développeurs : la documentation Responses indique que l’outil intégré web_search est pris en charge avec Pro et ignoré avec Flash. Cela ne signifie pas que Flash est incapable d’utiliser des résultats de recherche fournis par une application externe.
Notre recommandation : évaluez d’abord Flash lorsque votre priorité est le coût ou l’analyse visuelle. Comparez Pro sur les tâches textuelles pour lesquelles votre application dispose de critères de réussite précis, ou lorsqu’une fonctionnalité documentée de son intégration répond à un besoin particulier.
Ne migrez pas une application validée uniquement parce qu’un autre modèle est plus récent. Mais ne payez pas non plus davantage uniquement parce qu’un modèle s’appelle Pro. Mesurez les réponses correctes, les reprises nécessaires, la durée totale et les fonctions réellement disponibles. Pour situer les autres versions, consultez le guide de la famille DeepSeek V4.
Architecture : pourquoi Pro est puissant, mais lourd à héberger
La fiche Pro d’origine décrit un modèle MoE : un mécanisme de routage sélectionne certains experts pour chaque token. Les 49 milliards de paramètres actifs représentent une partie du calcul, pas la totalité des poids nécessaires à son fonctionnement.
L’infrastructure doit pouvoir accéder aux différents experts susceptibles d’être sollicités. Cette différence explique pourquoi Pro ne se déploie pas comme un modèle dense de 49 milliards de paramètres. Le format des poids, la mémoire et les échanges entre accélérateurs restent déterminants.
Attention hybride et optimisation de l’entraînement
Le rapport technique V4 décrit une attention hybride combinant Compressed Sparse Attention (CSA) et Heavily Compressed Attention (HCA), conçue pour améliorer l’efficacité des longs contextes. Il présente aussi les connexions mHC et l’optimiseur Muon, utilisés pour la stabilité et l’efficacité de l’entraînement.
Dans le scénario de contexte 1M étudié, les auteurs annoncent 27 % des opérations d’inférence par token et 10 % du cache KV de V3.2. Ce sont des comparaisons techniques dans un périmètre défini, pas une promesse de réduction identique de votre facture, de votre latence ou de votre consommation électrique.
Ce qu’ajoute Pro-0813
La fiche Pro-0813 décrit un modèle construit sur la structure Preview, avec un module de décodage spéculatif DSpark. Il s’agit d’un mécanisme d’inférence, pas d’un abonnement ni d’une nouvelle modalité visuelle. Ses possibilités d’accélération dépendent du moteur et de la configuration utilisés.
Performances : que montrent les évaluations de Pro-0813 ?
Le tableau de lancement publié par DeepSeek compare Pro-0813 à la préversion. Voici une sélection de résultats tirée de la model card officielle :
| Évaluation | Pro Preview | Pro-0813 |
|---|---|---|
| HLE sans outils | 37,7 | 42,7 |
| HLE avec outils | 48,2 | 60,0 |
| Terminal Bench 2.1 | 72,1 | 87,9 |
| DeepSWE | 12,8 | 62,7 |
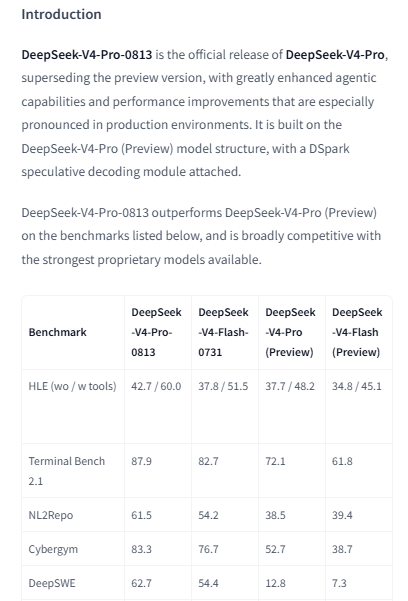
Ces chiffres proviennent du développeur. Pour les tâches publiques d’agents de code, la fiche précise l’utilisation de DeepSeek Harness en mode minimal et d’un effort max. Elle identifie séparément les évaluations DSBench internes, qui ne figurent pas dans notre sélection.
Ils soutiennent une amélioration de Pro-0813 sur les tests publiés, mais ne doivent pas être comparés directement à DeepSWE v1.1 ou Terminal-Bench 4.0. Un changement de version du benchmark ou d’environnement peut modifier la difficulté et la méthode de mesure.
Ce qu’apporte une évaluation indépendante
Artificial Analysis évalue séparément Pro-0813 en mode Max. Lors de la consultation, sa page affichait un score de 23 sur l’Intelligence Index v5.0, composé de neuf évaluations. Ce score n’est ni un pourcentage universel de bonnes réponses ni une mesure directement comparable à une ancienne version de l’indice.
L’évaluateur distingue également débit de sortie, délai initial et coût. Pour votre projet, gardez ces dimensions séparées : produire rapidement des tokens ne signifie pas toujours terminer plus vite une tâche comportant un long raisonnement et plusieurs outils.
Comment régler le raisonnement de V4 Pro ?
Le guide Thinking Mode indique que le raisonnement est activé par défaut, avec un effort high. Les niveaux documentés sont low, high et max. Le mode non-thinking reste disponible.
Pour une évaluation, commencez avec un réglage explicite. Comparez ensuite les niveaux seulement sur les tâches qui échouent ou restent incertaines. Cela permet d’observer si davantage de calcul apporte une amélioration suffisante pour son coût.
Avec Pro en thinking, la documentation indique que temperature et les pénalités n’ont pas d’effet. top_p est également fixé : 0,95 lorsque tools est présent, sinon 1,0. Les paramètres d’une recette d’auto-hébergement ne doivent donc pas être transposés sans contrôle à l’API hébergée.
Pour les appels de fonctions, vérifiez le protocole des outils : les résultats doivent être associés aux bons identifiants, et les messages nécessaires doivent être conservés. Un appel demandé par le modèle n’autorise pas automatiquement une modification de fichier ou de données métier.
Comment appeler DeepSeek V4 Pro avec l’API ?
Créez une clé sur la plateforme officielle, vérifiez votre solde et configurez DEEPSEEK_API_KEY dans l’environnement du serveur ou du terminal. Le Quick Start documente la base https://api.deepseek.com.
Voici un appel Chat Completions à exécuter dans un terminal compatible avec la syntaxe shell ci-dessous. Il sélectionne Pro explicitement, active le raisonnement et limite la génération :
: "${DEEPSEEK_API_KEY:?Définissez DEEPSEEK_API_KEY avant cet appel}"

curl --silent --show-error --fail --max-time 120 \
  https://api.deepseek.com/chat/completions \
  --header "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "deepseek-v4-pro",
    "messages": [
      {
        "role": "user",
        "content": "Propose en français trois tests pour une fonction qui calcule une moyenne. Explique le cas de la liste vide."
      }
    ],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "max_tokens": 4096,
    "stream": false
  }'
La réponse finale se lit dans choices[0].message.content. Contrôlez aussi finish_reason : une valeur length indique une génération interrompue par une limite. Le plafond de 4 096 tokens est un choix de démonstration ; il peut être insuffisant pour une tâche plus longue.
La syntaxe shell et le JSON de cet exemple ont été contrôlés localement, sans appel à l’API. L’option de délai du client ne prouve pas qu’aucun calcul n’a eu lieu si la connexion s’interrompt. Pour une application, ajoutez des erreurs lisibles, des budgets et des reprises limitées. Notre guide API DeepSeek approfondit l’intégration.
Pour contrôler les modèles accessibles à votre compte, utilisez l’endpoint GET /models. La compatibilité avec un SDK n’implique pas celle de toutes ses fonctions : DeepSeek Responses ne prend notamment pas en charge previous_response_id ou conversation, selon sa documentation.
Peut-on télécharger et utiliser Pro-0813 localement ?
Les dépôts DeepSeek-V4-Pro et DeepSeek-V4-Pro-0813 correspondent à des versions différentes. Choisissez le checkpoint et la révision nécessaires plutôt qu’un téléchargement portant seulement un nom voisin.
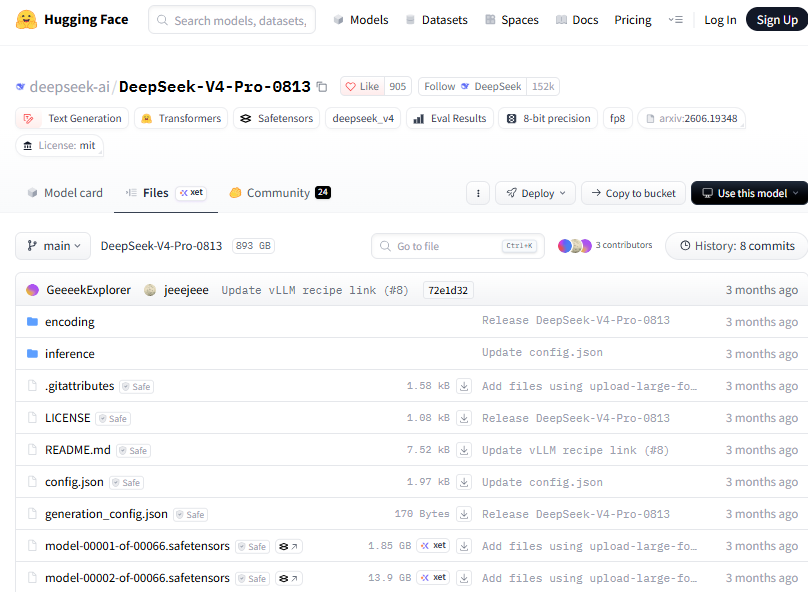
La licence MIT de Pro-0813 autorise des usages larges, y compris commerciaux, sous ses conditions, notamment la conservation des mentions requises. Vérifiez aussi les licences du moteur et des composants ajoutés. L’accès aux poids ne signifie pas que toutes les données d’entraînement sont publiées.
L’exécution complète relève d’une infrastructure spécialisée. La recette officielle vLLM documente des configurations multi-GPU, des formats mixtes de poids et des réglages spécifiques au contexte et au parallélisme. Ce n’est pas l’équivalent d’installer une application légère sur un ordinateur portable.
Ne déduisez pas un minimum matériel universel d’une seule commande de démonstration. Les poids, le cache, la longueur du contexte, la concurrence et les performances attendues doivent tous entrer dans le dimensionnement. Une quantification ou un modèle distillé ne représente pas non plus le même artefact.
Pour commencer, vérifiez le matériel réellement disponible, la recette compatible et le budget d’exploitation avant tout téléchargement massif. Le guide d’exécution locale aide à distinguer les différentes méthodes. N’exposez pas un serveur d’inférence sans contrôle d’accès et examinez le code distant avant de l’autoriser.
Quotas et données : les contrôles avant la production
La documentation des limites indique 500 requêtes simultanées pour Pro au niveau du compte. Une requête compte de son envoi jusqu’à la fin de la réponse. Il ne s’agit donc pas de 500 messages par minute, et créer plusieurs clés ne multiplie pas ce plafond.
Une application doit contrôler sa concurrence, gérer les réponses 429 et surveiller la durée totale des tâches. Pour un agent, incluez les appels d’outils et les reprises dans vos mesures, pas uniquement la vitesse de génération du texte.
Les conditions de la plateforme encadrent les obligations du développeur. Gardez la clé côté serveur, minimisez les données transmises et protégez les journaux. Ne supposez pas que l’utilisation d’une bibliothèque compatible apporte les garanties d’un autre hébergeur.
La politique DeepSeek décrit des traitements et un stockage de données personnelles en Chine pour les services qui y renvoient, tout en distinguant les applications développées par des tiers. Examinez les conditions applicables à votre flux précis. Un protocole sans état ne signifie pas « aucune conservation » ; des poids locaux ne garantissent pas une sécurité parfaite.
Pour des informations sensibles, faites valider les garanties et les autorisations nécessaires avant l’envoi. Notre dossier sur la sécurité de DeepSeek développe ces différences sans assimiler chat, API et auto-hébergement.
Quand choisir DeepSeek V4 Pro ?
Retenez Pro lorsque vos essais démontrent un avantage utile sur vos tâches, lorsqu’une intégration dépend de ses capacités documentées ou lorsque vous avez besoin du checkpoint Pro-0813. Le raisonnement complexe, la revue de code et les agents textuels sont des scénarios à évaluer, pas des garanties de supériorité.
Pour décider, préparez un petit jeu de demandes représentatives, avec des critères de réussite définis avant le test. Comparez Pro et Flash avec des outils et budgets appropriés, puis relevez qualité, erreurs, corrections, durée et coût. Conservez une version des résultats pour détecter les changements ultérieurs.
Enfin, « Pro » désigne ici un modèle, pas un abonnement universel. L’API est facturée à l’usage et l’auto-hébergement entraîne ses propres dépenses. Une offre commerciale tierce portant le même mot doit être examinée séparément.