
DeepSeek publie bien du code open source et les poids de plusieurs modèles sous des licences permissives, notamment MIT. En revanche, cela ne signifie pas que toute sa chaîne d’entraînement, ses données et son service en ligne sont ouverts. La réponse à « DeepSeek est-il open source ? » dépend donc du composant, de la version et de la définition utilisée.
Par exemple, le dépôt officiel DeepSeek-R1 annonce une licence MIT pour le dépôt et les poids. Cette publication accorde des possibilités réelles de réutilisation. Mais la licence d’un checkpoint ne suffit pas à établir l’ouverture du système complet selon l’Open Source AI Definition de l’OSI.
Pour votre projet, la question utile est donc double : quels éléments pouvez-vous obtenir, et que leur licence vous autorise-t-elle à faire ?
Dernière vérification documentaire : 29 octobre 2026.
Open source et open weights : pourquoi la distinction compte
Pour un logiciel, l’open source ne signifie pas seulement que son code est visible. Les conditions de distribution doivent permettre sa réutilisation, sa modification et son partage, selon les critères de l’Open Source Definition.
Un modèle d’IA comporte d’autres éléments. Ses poids sont les paramètres appris pendant l’entraînement. Un checkpoint est une version sauvegardée de ces paramètres. Le code d’inférence sert à exécuter le modèle, tandis que le code d’entraînement sert à produire ou à adapter ses paramètres.
Dans cet article, poids ouverts, ou open weights, désigne des poids distribués pour être téléchargés et utilisés selon une licence à examiner. Cette expression ne prouve ni la publication du corpus d’entraînement, ni celle du programme complet ayant produit le modèle.
La différence est concrète : vous pouvez disposer de ce qu’il faut pour exécuter un modèle, sans disposer de tous les éléments nécessaires pour reconstruire son entraînement. À l’inverse, une bibliothèque logicielle publiée par DeepSeek peut être réellement open source même si elle ne représente qu’une partie de son infrastructure.
Ce que DeepSeek publie effectivement
Les publications officielles vont au-delà de simples annonces. Elles comprennent des fichiers de modèles, des éléments d’exécution, des logiciels spécialisés et des documents techniques. Il faut toutefois évaluer chaque ensemble séparément.
| Élément | Exemple vérifié | Ce que cela permet de conclure |
|---|---|---|
| Poids et configuration du modèle | Checkpoints publiés dans l’organisation officielle DeepSeek sur Hugging Face | Les fichiers peuvent être obtenus ; leurs droits d’utilisation dépendent de leur licence |
| Éléments d’inférence et de préparation des messages | Dossiers inference et encoding du dépôt DeepSeek-V4.1-Flash-1017 | Des composants nécessaires à l’exécution sont publiés, sans que cela établisse la publication du pipeline d’entraînement complet |
| Logiciels d’infrastructure | DeepGEMM, bibliothèque de calcul sur GPU | Une contribution logicielle distincte, dont le code est distribué sous licence MIT |
| Informations sur les méthodes et données | Descriptions d’entraînement et Training Data Summaries | Des informations sont publiques, mais un résumé n’est pas un corpus complet téléchargeable |
DeepGEMM illustre une distinction importante : publier une bibliothèque de calcul sous MIT constitue une ouverture réelle de ce logiciel. Cela ne suffit cependant pas à documenter toutes les opérations de collecte, de filtrage et d’entraînement d’un modèle particulier.
Dans les ressources R1, V3 et V4.1 examinées ici, la publication d’un ensemble réunissant le code complet de préparation des données, de préentraînement et de post-entraînement n’a pas été établie. Ce constat porte sur ces sources : il ne revient pas à affirmer que DeepSeek ne publie aucun code lié à l’apprentissage.
Pourquoi une licence MIT ne suffit-elle pas au sens de l’OSI ?
L’Open Source AI Definition 1.0, publiée par l’Open Source Initiative, ne se limite pas à la licence des poids. Elle examine les moyens nécessaires pour utiliser, étudier, modifier et partager un système d’IA.
Son cadre couvre notamment les paramètres, le code utilisé pour entraîner et exécuter le système, ainsi que des informations suffisamment détaillées sur les données. L’objectif est de permettre à une personne compétente de construire un système substantiellement équivalent, pas d’exiger une reproduction identique bit à bit.
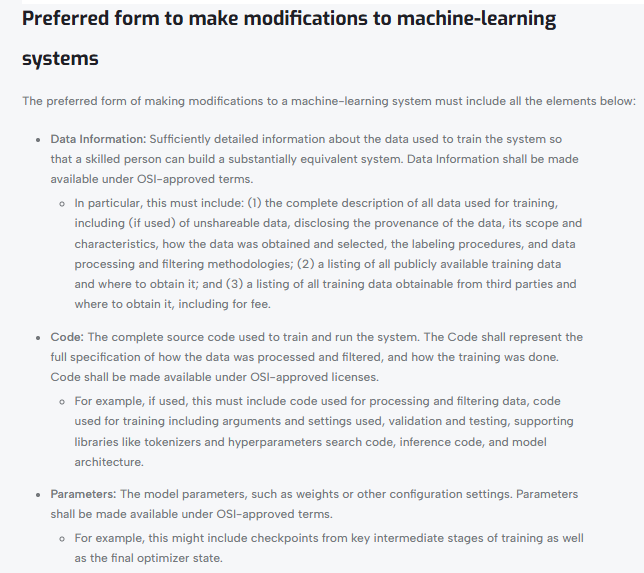
Ainsi, un fichier LICENSE portant la mention MIT ne prouve pas, à lui seul, que tous les éléments attendus par ce référentiel sont disponibles. Il faut vérifier ce qui accompagne réellement le modèle. Ce cadre doit être nommé lorsqu’il sert à évaluer l’ouverture ; ce n’est pas une loi universelle sur la commercialisation de l’IA.
Faut-il publier toutes les données brutes d’entraînement ?
Pas systématiquement. La FAQ officielle de l’OSI distingue les données ouvertes, publiques, accessibles auprès de tiers et celles qui ne peuvent pas être partagées pour des raisons explicables.
Elle demande notamment le partage des données ouvertes, l’identification des sources accessibles et une description détaillée des données non partageables. Présenter l’OSAID comme une obligation de publier chaque donnée brute sans exception serait donc inexact.
L’erreur inverse serait de considérer qu’une description générale du corpus suffit toujours. La question est celle du niveau d’information effectivement fourni, avec le code et les paramètres nécessaires à une modification substantielle du système.
Les licences DeepSeek diffèrent selon les versions
Il n’existe pas une licence unique à appliquer automatiquement à tous les modèles portant le nom DeepSeek. Voici quatre exemples qui montrent pourquoi l’identifiant exact du checkpoint est indispensable.
| Publication | Licence documentée | Point à retenir |
|---|---|---|
| DeepSeek-R1 et R1-Zero | MIT pour le dépôt et les poids, selon le README officiel | Les variantes distillées demandent une vérification supplémentaire du modèle de base |
| DeepSeek-V3 original | MIT pour le code ; licence DeepSeek spécifique pour le modèle | Ne pas étendre la licence du code aux poids |
| DeepSeek-V3-0324 | MIT pour le dépôt et les poids, confirmé par sa model card et son fichier LICENSE | Cette publication doit être distinguée du V3 original |
| DeepSeek-V4.1-Flash-1017 | MIT pour le dépôt et les poids, selon la fiche officielle et la licence distribuée | Un exemple récent de poids publiés sous licence permissive, sans preuve automatique d’ouverture de tout l’entraînement |
Pourquoi le cas du V3 original est-il important ?
Le README de DeepSeek-V3 sépare explicitement le code, sous MIT, des modèles Base et Chat, soumis à la licence du modèle. Il indique que l’usage commercial est permis, mais cela ne supprime pas les conditions de cette licence.
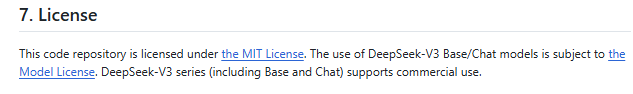
Son annexe A comporte des restrictions d’usage, notamment concernant l’utilisation militaire. Ce texte n’est donc pas équivalent à une licence MIT sans restriction sectorielle. Il ne faut ni le présenter comme MIT, ni reporter automatiquement ses restrictions sur V3-0324 ou sur une autre génération.
Pour éviter cette confusion, notez le nom complet de la publication. « DeepSeek-V3 » et « DeepSeek-V3-0324 » ne constituent pas une référence suffisamment interchangeable pour décider des droits d’utilisation.
Attention aux modèles DeepSeek-R1 distillés depuis Qwen ou Llama
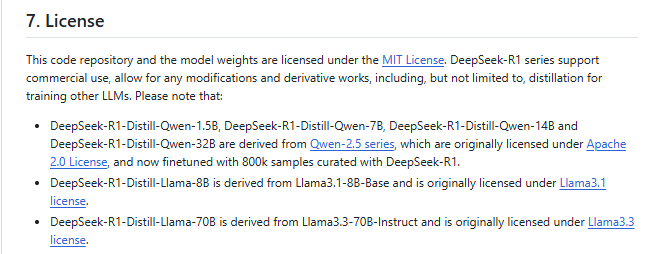
Une version distillée n’est pas simplement le modèle R1 complet rendu plus petit. Les variantes publiées par DeepSeek reposent sur des modèles de base déterminés, ajustés à l’aide d’exemples issus de R1. Leurs licences d’origine doivent donc faire partie de la vérification.
Exemple : DeepSeek-R1-Distill-Qwen-7B
Le tableau officiel des variantes R1 identifie Qwen2.5-Math-7B comme modèle de base de DeepSeek-R1-Distill-Qwen-7B. Le fichier de licence de ce modèle Qwen contient Apache License 2.0.
Pour une redistribution, Apache 2.0 prévoit notamment la fourniture de la licence, la conservation de certaines mentions, l’indication des fichiers modifiés et le traitement d’un éventuel fichier NOTICE. Ces obligations sont détaillées dans la section 4 du texte officiel. Elles ne doivent pas être remplacées par les seules règles résumées pour MIT.
Exemple : DeepSeek-R1-Distill-Llama-8B
DeepSeek identifie Llama-3.1-8B comme base de cette variante. Sa licence Llama 3.1 n’est pas MIT : elle contient notamment des règles d’attribution et de redistribution, dont une mention « Built with Llama » dans les situations couvertes par le texte.
La conclusion pratique n’est pas que tous les DeepSeek héritent de ces conditions. Elle est plus précise : pour une variante dérivée, lisez les indications de DeepSeek et la licence du modèle de base. Une étiquette MIT sur une page ne suffit pas à effacer les droits et obligations associés aux composants d’origine.
Peut-on utiliser DeepSeek commercialement, le modifier ou le redistribuer ?
Oui pour les composants publiés sous une licence qui autorise ces usages, à condition d’en respecter les termes. Pour les éléments couverts par MIT, le texte de la licence permet notamment l’utilisation, la modification, la distribution et la vente de copies.
Faut-il publier le code de son application ?
MIT n’impose pas, à elle seule, de publier tout le code d’une application propriétaire utilisant un composant sous cette licence. Elle impose en revanche de conserver la mention de copyright et la notice d’autorisation dans les copies ou parties substantielles concernées.
Modifier un composant, distribuer des poids adaptés et proposer un service hébergé sont des situations différentes. Vérifiez les autres dépendances et conditions applicables : une conclusion valable pour un checkpoint MIT ne vaut pas automatiquement pour un assemblage comportant une licence Llama ou une licence DeepSeek historique.
Que signifie « modification » dans ce contexte ?
Un fine-tuning adapte un modèle par un entraînement supplémentaire. Une distillation utilise les résultats d’un modèle pour en entraîner un autre. Une quantification réduit la précision numérique de certains paramètres pour faciliter leur stockage ou leur exécution.
DeepSeek indique expressément que la série R1 permet des modifications et travaux dérivés, y compris la distillation. Cela ne dispense pas de vérifier la provenance d’une variante ni les conditions des autres composants utilisés.
Les réponses générées sont-elles automatiquement sous licence MIT ?
Ne confondez pas la licence des poids avec les droits sur chaque sortie. Pour l’API officielle, les conditions de la plateforme traitent séparément les entrées et les sorties, sous réserve du droit applicable et des conditions du service.
La licence d’un modèle ne garantit pas non plus que toute réponse est exempte de droits de tiers, ni que vous pouvez revendiquer une affiliation officielle avec DeepSeek. Pour une redistribution complexe ou un usage commercial sensible, faites examiner le montage de licences correspondant à votre produit.
DeepSeek publie-t-il ses données et son code d’entraînement ?
DeepSeek publie des informations sur son entraînement, mais ces documents ne sont pas équivalents à la mise à disposition du corpus complet et de tous les scripts. Il serait donc inexact d’affirmer qu’aucune information n’est publique, comme de conclure que tout est reproductible à partir d’un rapport.
La page officielle Model Mechanism and Training Methods présente les grandes étapes de développement et renvoie vers des résumés des données d’entraînement de plusieurs générations.
Le résumé public pour DeepSeek-V4.1, daté du 24 septembre 2026, mentionne notamment Common Crawl, Stack Exchange, des données sous licence et des données privées provenant de tiers. Il décrit certaines opérations de sélection et de filtrage, sans fournir pour autant un corpus complet prêt à être téléchargé.
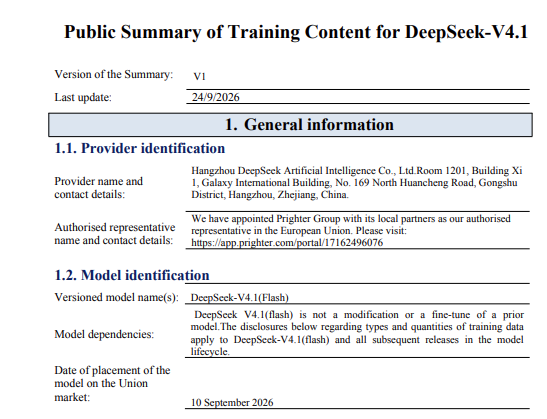
Un document distinct pour V3.1 et V3.2 porte une date de mise à jour du 13 octobre 2026. Ces publications doivent être prises en compte avant de reprendre une analyse historique de la transparence de DeepSeek.
Leur existence ne démontre toutefois pas, à elle seule, que toutes les exigences de l’OSAID sont remplies. Une description des sources, une liste de jeux de données, les données elles-mêmes et le code exécutant leur préparation constituent des éléments différents.
Pour reproduire un entraînement, il faut aussi examiner les paramètres, les étapes et les programmes effectivement disponibles. Un script permettant de charger des poids et de générer une réponse répond à un autre besoin : exécuter le résultat d’un entraînement déjà réalisé.
Le chatbot et l’API DeepSeek sont-ils eux-mêmes open source ?
La publication de poids ne prouve pas l’ouverture de toute l’application qui les utilise. L’interface de chat, les serveurs, les outils, la gestion des comptes et les mécanismes de production sont des composants distincts. Les ressources citées ici ne permettent pas de présenter l’intégralité du service hébergé comme un système dont tout le code serait publié.
Les conditions de la DeepSeek Open Platform régissent l’utilisation de son API et de ses outils développeurs. Elles ne doivent pas être confondues avec le fichier de licence accompagnant un checkpoint téléchargé.
De même, une documentation publique ou un format compatible avec un SDK ne donne pas automatiquement accès au code du service. Vous pouvez savoir comment appeler une API sans pouvoir reconstruire l’infrastructure qui la fournit.
Pourquoi l’API peut-elle être payante si les poids sont ouverts ?
Une licence de réutilisation et une prestation d’hébergement ne couvrent pas la même chose. DeepSeek facture les appels de modèles selon les conditions de sa page Models & Pricing. L’accès aux fichiers n’oblige pas le fournisseur à réaliser gratuitement les calculs pour votre application.
L’auto-hébergement évite de dépendre de cet endpoint particulier, mais implique ses propres dépenses : ressources de calcul, stockage, exploitation et maintenance. Il faut également vérifier que votre environnement peut exécuter le modèle choisi ; l’accès aux poids ne garantit pas une installation simple sur un ordinateur personnel.
Comment vérifier une licence DeepSeek avant utilisation ?
Vous pouvez effectuer une première vérification sans clé API et sans télécharger les fichiers volumineux du modèle. L’objectif est de documenter précisément ce que vous comptez utiliser.
- Identifiez le checkpoint exact. Notez son organisation, son nom complet et sa révision. Un alias de service ou une appellation comme « DeepSeek V3 » peut être insuffisant.
- Lisez la model card et les fichiers de licence. Recherchez
LICENSE,LICENSE-CODE,LICENSE-MODELet les éventuelles notices. Déterminez à quels fichiers ils s’appliquent. - Remontez à l’origine des modèles dérivés. Pour une version distillée, ajustée ou quantifiée, identifiez le modèle de base et vérifiez ses propres conditions.
- Définissez votre usage. Distinguez expérimentation interne, modification, distribution des poids, commercialisation d’une application et service hébergé. Relevez les obligations correspondant à votre cas.
- Conservez une trace de la vérification. Archivez les textes de licence, les notices, la révision du dépôt et la date examinée. Réévaluez ces points lorsque vous changez de checkpoint.
Le dépôt V3 original fournit un bon exercice : son fichier LICENSE-CODE contient MIT, alors que LICENSE-MODEL contient un autre texte. Lire uniquement le premier peut donc conduire à une conclusion incorrecte sur les poids.
Questions complémentaires sur l’ouverture de DeepSeek
Un dépôt public sur GitHub suffit-il à autoriser la réutilisation ?
Non. La documentation GitHub sur les licences rappelle qu’en l’absence de licence, les règles ordinaires du droit d’auteur s’appliquent. La possibilité de consulter ou de créer un fork sur la plateforme ne constitue pas une autorisation générale de commercialiser ou redistribuer le contenu.
Une quantification communautaire peut-elle remplacer la licence d’origine ?
Ne le supposez pas. Une conversion de format ou de précision ne constitue pas, par elle-même, une autorisation de supprimer les obligations attachées aux éléments d’origine. Vérifiez la provenance du fichier, la licence du checkpoint source et les notices de la conversion, même si la page communautaire affiche une autre étiquette.
Exécuter un modèle ouvert localement garantit-il la confidentialité ?
Non. Pour évaluer votre configuration, examinez aussi l’application utilisée, les connexions réseau, les journaux, les outils externes et les permissions d’accès. Héberger les poids sur votre machine et vérifier qu’aucune donnée ne sort de votre environnement sont deux contrôles distincts.
Quelle conclusion retenir pour votre projet ?
DeepSeek offre une ouverture réelle de nombreux poids et composants logiciels, mais « tout DeepSeek est open source » reste une formulation trop générale. Pour déployer ou commercialiser une solution, partez du checkpoint exact et de ses licences. Pour étudier ou reproduire son développement, examinez en plus le code d’entraînement et les informations relatives aux données.
La formulation la plus utile précise donc le modèle, les éléments publiés et les droits accordés. « Les poids de ce checkpoint sont distribués sous MIT » est une affirmation vérifiable ; « toute la plateforme et tout son entraînement sont ouverts » exige des preuves supplémentaires.