
DeepSeek R1 est un modèle d’intelligence artificielle spécialisé dans le raisonnement, développé par DeepSeek et lancé le 20 janvier 2025. Il a été conçu pour résoudre des problèmes nécessitant plusieurs étapes d’analyse, notamment en mathématiques, en programmation et en logique. Son entraînement repose largement sur l’apprentissage par renforcement (reinforcement learning).
Le modèle original compte 671 milliards de paramètres, dont environ 37 milliards sont activés par jeton. Depuis son lancement, DeepSeek a publié une mise à jour appelée DeepSeek-R1-0528, ainsi que plusieurs modèles plus petits, dits distillés, qui peuvent être exécutés sur des configurations matérielles moins importantes.
En octobre 2026, DeepSeek R1 n’est plus le modèle actuellement proposé par défaut sur le site et l’API officiels. Ses poids restent néanmoins téléchargeables pour une utilisation locale, et certains fournisseurs externes continuent de proposer des modèles de cette famille. Ce guide explique les différences entre ses versions, ses performances, les moyens de l’utiliser et les situations dans lesquelles un modèle DeepSeek plus récent peut être préférable.
Qu’est-ce que DeepSeek R1 et pourquoi a-t-il marqué l’IA ?
DeepSeek R1 appartient à une catégorie de modèles de langage orientés vers le raisonnement. Alors qu’un modèle généraliste peut produire rapidement une réponse directe, un modèle de raisonnement est entraîné pour consacrer davantage de calcul à la décomposition et à la résolution de problèmes complexes.
Dans son annonce officielle du 20 janvier 2025, DeepSeek présentait R1 comme un modèle capable d’obtenir des performances comparables à celles d’OpenAI o1 sur certaines évaluations de mathématiques, de code et de raisonnement. L’entreprise publiait simultanément ses poids et son rapport technique sous une licence permettant notamment l’utilisation commerciale et la création de modèles dérivés.
L’intérêt de R1 était donc double : démontrer les possibilités de l’apprentissage par renforcement pour améliorer le raisonnement et rendre accessibles les poids d’un modèle de très grande taille. Il est ainsi devenu une référence importante pour les développeurs et chercheurs souhaitant étudier ou adapter des modèles de raisonnement.
Caractéristiques du modèle original
| Développeur | DeepSeek AI |
|---|---|
| Date de sortie | 20 janvier 2025 |
| Type | Grand modèle de langage spécialisé dans le raisonnement |
| Architecture | Mixture-of-Experts (MoE), fondée sur DeepSeek-V3-Base |
| Paramètres totaux | 671 milliards |
| Paramètres activés par jeton | Environ 37 milliards |
| Fenêtre de contexte de référence | 128 000 jetons |
| Modalité originale | Texte en entrée et en sortie |
| Licence du modèle complet | MIT |
| Principaux usages | Mathématiques, programmation, logique, analyse et recherche |
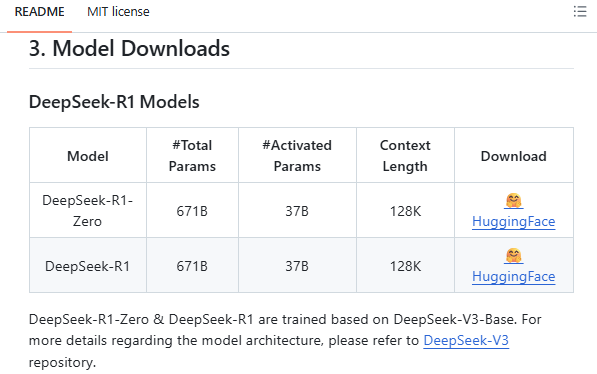
Ces spécifications correspondent au modèle publié dans le dépôt officiel DeepSeek-R1 sur GitHub. Les modèles distillés et les distributions proposées par des outils comme Ollama peuvent posséder des tailles, des formats de poids et des limites pratiques différents.
Comment fonctionne le raisonnement de DeepSeek R1 ?
Le fonctionnement de R1 repose sur deux éléments importants : une architecture efficace pour un modèle de grande taille et un entraînement destiné à améliorer la résolution de problèmes en plusieurs étapes.
L’apprentissage par renforcement
L’apprentissage par renforcement permet d’améliorer un modèle en évaluant les réponses ou comportements qu’il produit. Dans certaines tâches mathématiques ou de programmation, il est possible d’attribuer une récompense selon que le résultat satisfait ou non une condition vérifiable.
Les chercheurs de DeepSeek ont notamment étudié comment un modèle pouvait développer des comportements de raisonnement plus élaborés grâce à un entraînement par renforcement à grande échelle.
Le rapport de recherche DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning décrit cette démarche. Il distingue deux modèles : R1-Zero, entraîné initialement sans étape préalable de fine-tuning supervisé, et R1, qui utilise un processus en plusieurs phases avec des données de démarrage (cold-start) et des étapes supplémentaires d’ajustement.
Pourquoi DeepSeek R1 peut-il consacrer plus de temps à une réponse ?
Un problème de raisonnement peut nécessiter plusieurs opérations intermédiaires. Par exemple, pour résoudre un exercice de programmation, le modèle peut devoir identifier les contraintes, concevoir un algorithme, examiner les cas particuliers et formuler une solution finale.
Cette génération supplémentaire peut améliorer les résultats sur certaines tâches complexes, mais elle augmente également le nombre de jetons produits et parfois le délai de réponse.
Il ne faut pas confondre un raisonnement détaillé avec une réponse nécessairement correcte. Un modèle peut produire une démonstration convaincante contenant une erreur de calcul ou une hypothèse non fondée. Les résultats importants doivent toujours être vérifiés indépendamment.
Le rôle de Mixture-of-Experts
DeepSeek R1 utilise une architecture Mixture-of-Experts dans laquelle une partie des paramètres est sélectionnée pour traiter chaque jeton, plutôt que d’activer systématiquement l’intégralité du réseau.
Le modèle complet possède ainsi environ 671 milliards de paramètres, mais environ 37 milliards sont mobilisés par jeton. Cette architecture permet de limiter la quantité de calcul active lors de l’inférence.
Cela ne signifie pas que R1 peut fonctionner avec la mémoire d’un modèle dense de 37 milliards de paramètres. Les poids, les experts et les ressources nécessaires au traitement du contexte demeurent considérables.
DeepSeek R1, R1-Zero, R1-0528 et Distill : quelles différences ?
La famille DeepSeek R1 comprend plusieurs modèles aux objectifs différents. Les distinguer est indispensable avant de consulter des benchmarks, de télécharger des poids ou de suivre un tutoriel d’installation.
| Modèle | Caractéristique principale | Usage pertinent |
|---|---|---|
| DeepSeek-R1-Zero | Modèle de recherche entraîné avec un apprentissage par renforcement sans fine-tuning supervisé préalable | Étudier l’émergence des comportements de raisonnement |
| DeepSeek-R1 | Version originale du 20 janvier 2025, avec entraînement en plusieurs étapes | Reproduire des expériences et utiliser le modèle historique |
| DeepSeek-R1-0528 | Mise à jour du 28 mai 2025 améliorant le raisonnement et plusieurs capacités pratiques | Utiliser une version plus aboutie de la famille R1 |
| DeepSeek-R1-Distill | Famille de modèles plus petits issus de Qwen et Llama, ajustés avec des données de raisonnement de R1 | Expérimentation locale sur des ressources plus modestes |
| DeepSeek-R1-0528-Qwen3-8B | Modèle de 8 milliards de paramètres dérivé de Qwen3 et amélioré avec des données de R1-0528 | Tester localement une version compacte issue de la mise à jour 0528 |
R1-Zero : la démonstration expérimentale
DeepSeek-R1-Zero a été entraîné afin d’étudier les capacités de raisonnement pouvant apparaître par apprentissage par renforcement, sans commencer par une étape de fine-tuning supervisé.
Le rapport de recherche décrit des comportements intéressants, mais aussi des difficultés de lisibilité et des mélanges de langues. Ces limites ont contribué au développement du modèle R1 destiné à offrir des réponses plus utilisables.
Les poids de la version expérimentale sont disponibles dans le dépôt DeepSeek-R1-Zero sur Hugging Face.
R1-0528 : la mise à jour de mai 2025
La version DeepSeek-R1-0528 a été présentée officiellement le 28 mai 2025. Elle conserve la grande architecture de R1, mais bénéficie d’améliorations de l’entraînement et du raisonnement.
Dans son annonce officielle de R1-0528, DeepSeek mentionne notamment des résultats supérieurs sur plusieurs évaluations, une meilleure génération de pages Web, une réduction des hallucinations et la prise en charge de JSON Output et du Function Calling dans cette version.
Deux différences pratiques sont également signalées dans sa fiche officielle Hugging Face : le modèle accepte désormais les messages système et il n’est plus nécessaire d’ajouter artificiellement un préfixe <think> pour déclencher son comportement de raisonnement.
Ces instructions sont spécifiques à R1-0528. Les recommandations de prompting d’un modèle ne doivent pas être transposées automatiquement à une autre version.
Que signifie « Distill » dans DeepSeek R1 ?
La distillation consiste ici à utiliser des données de raisonnement issues d’un grand modèle pour entraîner ou ajuster des modèles plus petits. L’objectif est de transférer une partie des compétences du modèle enseignant sans reproduire sa taille ou son architecture.
DeepSeek a publié six modèles distillés initiaux fondés sur les familles Qwen2.5 et Llama 3, avec des tailles de 1,5B, 7B, 8B, 14B, 32B et 70B paramètres.
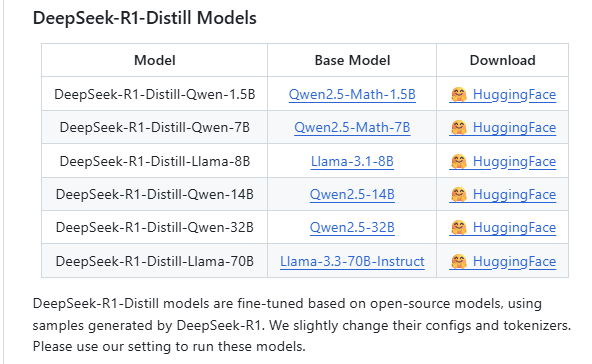
Par exemple, DeepSeek-R1-Distill-Qwen-7B et DeepSeek-R1-Distill-Llama-8B sont deux modèles distincts. Ils n’ont ni la même architecture de base ni nécessairement les mêmes conditions de licence.
Le modèle DeepSeek-R1-0528-Qwen3-8B est une distillation ultérieure fondée sur Qwen3. Il ne doit pas être confondu avec le modèle Llama 8B de la première série ni avec la version complète de R1-0528.
Performances de DeepSeek R1 : que montrent les benchmarks ?
Les résultats publiés lors du lancement de DeepSeek R1 montraient de bonnes performances sur les tâches mathématiques et de raisonnement, notamment face à certains modèles disponibles début 2025. La mise à jour R1-0528 a ensuite amélioré plusieurs de ces scores.
Voici trois résultats extraits de la documentation officielle de DeepSeek-R1-0528 :
| Benchmark | R1 original | R1-0528 | Ce qu’il évalue |
|---|---|---|---|
| AIME 2025 — Pass@1 | 70,0 % | 87,5 % | Résolution de problèmes mathématiques de compétition |
| GPQA Diamond — Pass@1 | 71,5 % | 81,0 % | Questions scientifiques exigeantes |
| LiveCodeBench (2408–2505) — Pass@1 | 63,5 % | 73,3 % | Résolution de problèmes de programmation |
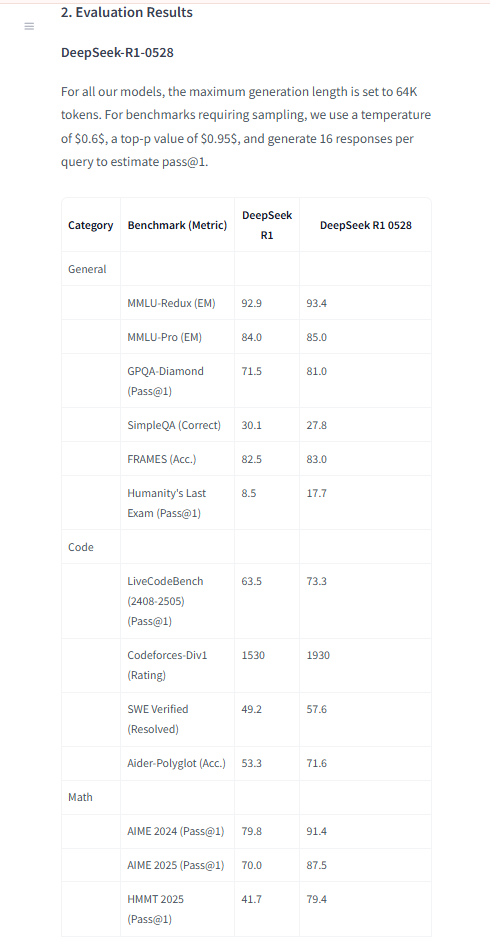
Ces chiffres proviennent des évaluations publiées par DeepSeek en mai 2025 et ne sont pas des mesures indépendantes réalisées en octobre 2026. Le développeur précise notamment que certaines estimations de Pass@1 utilisent plusieurs générations par question et que le budget de sortie peut atteindre 64 000 jetons dans son protocole d’évaluation.
Les résultats montrent l’amélioration historique entre deux versions de R1, pas un classement universel des modèles actuels. Ils ne permettent pas d’affirmer que R1-0528 surpasse systématiquement les dernières versions de ChatGPT, Gemini, Claude ou les modèles DeepSeek plus récents.
Les benchmarks suffisent-ils à choisir un modèle ?
Non. Les benchmarks évaluent des compétences particulières dans des conditions définies. Un bon résultat sur des exercices mathématiques ne garantit pas qu’un modèle analysera parfaitement un contrat ou produira systématiquement du code sûr.
Pour choisir un modèle, préparez plusieurs tâches représentatives de votre usage, vérifiez les réponses et comparez la précision, la latence, les erreurs, les ressources nécessaires et le coût total.
Comment utiliser DeepSeek R1 en 2026 ?
Plusieurs méthodes existent, mais elles n’exécutent pas nécessairement le même modèle. Si vous voulez retrouver précisément DeepSeek R1, vérifiez le nom complet de la variante et le fournisseur.
| Accès | Possibilité actuelle | À vérifier |
|---|---|---|
| Site officiel DeepSeek | Utiliser les modèles actuellement proposés sur le Web | Ce n’est pas une garantie d’accès au R1 original. |
| API officielle DeepSeek | Utiliser les modèles actuellement documentés | R1 n’est pas dans le catalogue API actuel. |
| Hugging Face | Télécharger les poids des versions R1 | Version exacte, licence et ressources matérielles. |
| Ollama | Lancer des distributions locales de R1 ou de ses modèles distillés | Tag, quantification et modèle réel. |
| LM Studio ou autre moteur local | Utiliser un modèle converti compatible | Format des poids et moteur d’inférence. |
| Fournisseur d’inférence tiers | Accéder éventuellement à une version R1 hébergée | Identifiant exact, prix et politique de données. |
Le site officiel utilise-t-il encore DeepSeek R1 ?
Les premières documentations DeepSeek R1 expliquaient comment accéder au modèle grâce au bouton DeepThink sur chat.deepseek.com. Cette description correspondait à la période du lancement.
Depuis, les modèles proposés ont évolué. Le journal officiel du 17 octobre 2026 indique que les versions Web et application ont été mises à jour vers DeepSeek-V4.1-Flash-1017.
Il ne faut donc pas considérer le bouton DeepThink comme un sélecteur garantissant l’exécution des poids DeepSeek-R1 de janvier 2025. DeepThink désigne un mode de fonctionnement, tandis que DeepSeek-R1 est un modèle précis.
Peut-on encore appeler R1 par l’API DeepSeek ?
Au lancement de janvier 2025, DeepSeek indiquait que l’API permettait d’appeler R1 à l’aide de l’identifiant deepseek-reasoner. Cependant, cet identifiant a ensuite été associé à plusieurs générations différentes de modèles.
Le 24 avril 2026, DeepSeek a annoncé que les anciens identifiants deepseek-chat et deepseek-reasoner seraient supprimés le 24 juillet 2026. Pendant la période de transition, ils étaient redirigés vers des modes du modèle V4 Flash.
En octobre 2026, la page officielle des modèles API présente notamment deepseek-flash et deepseek-v4-pro. Aucun de ces identifiants ne correspond au R1 original.
Pour utiliser précisément R1 avec une API, vous devez donc examiner un hébergement indépendant proposant explicitement les poids souhaités ou déployer le modèle sur une infrastructure compatible. L’API officielle actuelle ne doit pas être présentée comme un endpoint R1 historique.
Installer DeepSeek R1 localement avec Ollama
Ollama est un moyen pratique d’essayer certains modèles R1 sur son ordinateur. Il télécharge les fichiers nécessaires et fournit une interface de conversation depuis le terminal.
Il existe néanmoins une distinction capitale : la commande ollama run deepseek-r1 ne télécharge pas le modèle complet de 671 milliards de paramètres. Selon le catalogue Ollama consulté le 26 octobre 2026, elle charge par défaut une distribution de DeepSeek-R1-0528-Qwen3-8B, un modèle distillé de 8 milliards de paramètres.
Étape 1 : installer Ollama
- Rendez-vous sur la page officielle de téléchargement d’Ollama.
- Choisissez la version adaptée à Windows, macOS ou Linux.
- Suivez les instructions d’installation propres à votre système.
- Ouvrez ensuite un terminal et vérifiez l’installation avec :
ollama --versionSi la commande n’est pas reconnue, vérifiez que l’installation s’est terminée correctement et que l’exécutable est accessible depuis votre terminal.
Étape 2 : choisir une variante R1
Pour obtenir explicitement le modèle distillé DeepSeek-R1-0528-Qwen3-8B proposé par Ollama, utilisez :
ollama run deepseek-r1:8bCe tag correspond actuellement à une distribution d’environ 5,2 Go. Le téléchargement peut être volumineux lors du premier lancement.
Pour essayer un modèle plus petit de la série originale, vous pouvez utiliser :
ollama run deepseek-r1:1.5bCette commande charge une version distillée fondée sur Qwen2.5-Math-1.5B, et non le modèle 8B de mai 2025. Elle est plus légère, mais ses capacités de raisonnement sont également plus limitées sur certaines tâches.
Étape 3 : tester le raisonnement du modèle
Dans la session interactive Ollama, utilisez par exemple cette instruction :
Un programme doit répartir 137 tâches entre quatre serveurs de capacités identiques. Chaque tâche est indivisible. Explique comment calculer une répartition équilibrée, donne le nombre de tâches par serveur et indique comment vérifier que la somme est correcte.
Ce type de question permet d’observer la capacité du modèle à décomposer un problème, proposer une méthode et produire un résultat contrôlable.
L’exemple est illustratif : aucun modèle Ollama n’a été exécuté pour cet article. Pour vérifier une réponse, refaites les calculs indépendamment plutôt que de considérer l’explication du modèle comme une preuve.
Étape 4 : vérifier le modèle installé
Dans un terminal, utilisez :
ollama listCette commande affiche les modèles présents localement. Vous pouvez également consulter les informations d’un modèle précis :
ollama show deepseek-r1:8bVérifiez le tag et les informations du modèle avant de comparer ses réponses à des résultats publiés pour une autre version.
Quel modèle DeepSeek R1 choisir selon son ordinateur ?
Les différences de taille sont considérables. Voici les principales distributions présentées dans le catalogue officiel Ollama pour DeepSeek R1 :
| Tag Ollama | Distribution | Taille du téléchargement |
|---|---|---|
deepseek-r1:1.5b | Distill-Qwen 1.5B | Environ 1,1 Go |
deepseek-r1:7b | Distill-Qwen 7B | Environ 4,7 Go |
deepseek-r1:8b | R1-0528-Qwen3-8B | Environ 5,2 Go |
deepseek-r1:14b | Distill-Qwen 14B | Environ 9 Go |
deepseek-r1:32b | Distill-Qwen 32B | Environ 20 Go |
deepseek-r1:70b | Distill-Llama 70B | Environ 43 Go |
deepseek-r1:671b | Modèle complet R1 publié par Ollama | Environ 404 Go |
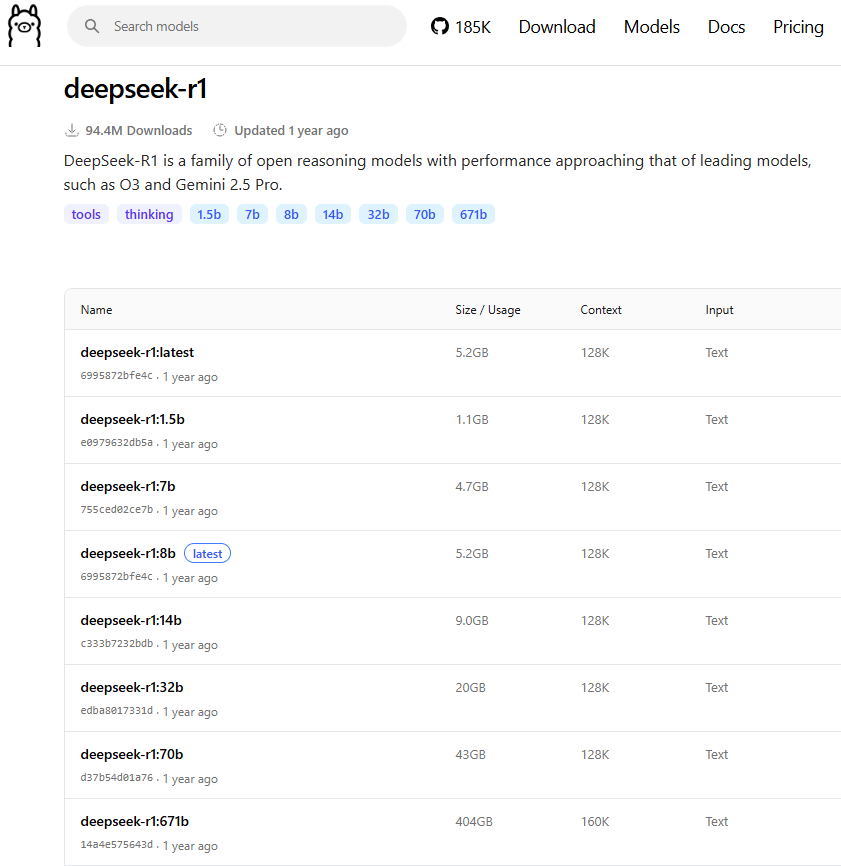
Attention : la taille du téléchargement ne représente pas la mémoire RAM ou VRAM totale nécessaire pendant l’inférence. Les besoins augmentent notamment avec la fenêtre de contexte, le cache KV, le moteur d’inférence et le nombre de requêtes traitées.
Le modèle complet de 671B appartient à une catégorie d’infrastructure très différente des distributions 1.5B ou 8B. Il n’est pas réaliste de supposer qu’il fonctionnera confortablement sur un ordinateur portable classique.
Une exécution sur CPU peut être envisagée pour certaines petites versions, mais elle peut être lente. Une carte graphique disposant de mémoire suffisante peut accélérer le traitement, sous réserve de la compatibilité du runtime et du format des poids.
Enfin, la fenêtre de contexte dépend aussi de l’hébergement. Les spécifications officielles du R1 original mentionnent 128K jetons, tandis que certaines distributions Ollama annoncent des limites différentes, notamment 160K pour leur package 671B. La valeur effectivement utilisable doit être vérifiée dans le moteur choisi.
Peut-on télécharger DeepSeek R1 depuis Hugging Face ?
Oui. Les dépôts officiels permettent d’accéder à des versions précises du modèle :
- DeepSeek-R1 : poids du modèle original de janvier 2025.
- DeepSeek-R1-Zero : version expérimentale de recherche.
- DeepSeek-R1-0528 : mise à jour complète de mai 2025.
- DeepSeek-R1-0528-Qwen3-8B : variante compacte fondée sur Qwen3.
- DeepSeek-R1-Distill-Qwen-32B : exemple de modèle distillé issu de la première famille.
Télécharger les poids ne suffit pas pour lancer automatiquement un chatbot. Il faut également un moteur d’inférence compatible, suffisamment de ressources et une configuration adaptée au modèle, notamment pour le tokenizer et le format de conversation.
Des versions quantifiées proposées par la communauté peuvent réduire les besoins en mémoire, mais elles doivent être évaluées séparément. La quantification peut modifier la qualité des réponses, et les instructions d’un dépôt communautaire ne constituent pas nécessairement des recommandations officielles de DeepSeek.
DeepSeek R1 est-il gratuit et open source ?
Les poids du modèle original DeepSeek R1 ont été publiés sous licence MIT, avec des droits permettant notamment l’utilisation, la modification, la redistribution et la commercialisation sous réserve du respect des conditions de cette licence.
Cependant, les modèles distillés exigent une lecture plus attentive des conditions applicables à leur architecture de base.
| Famille | Licence à examiner |
|---|---|
| DeepSeek-R1 complet | Licence MIT du modèle officiel |
| DeepSeek-R1-0528 | Licence MIT du modèle officiel |
| Distill-Qwen2.5 | Licence DeepSeek et obligations applicables aux bases Qwen2.5, notamment Apache 2.0 |
| Distill-Llama 8B et 70B | Licence DeepSeek et conditions des modèles Meta Llama correspondants |
| Distillation R1-0528-Qwen3-8B | Licence publiée pour les poids et conditions applicables au modèle de base utilisé |
Le dépôt officiel DeepSeek-R1 détaille ces distinctions. La publication des poids sous MIT ne signifie pas que toutes les données d’entraînement, tous les outils utilisés pendant l’entraînement ou toutes les versions dérivées possèdent automatiquement les mêmes obligations.
La gratuité du téléchargement ne supprime pas non plus les coûts d’exploitation : matériel, électricité, stockage, serveur GPU éventuel et maintenance.
À l’inverse, utiliser un fournisseur hébergeant R1 implique de vérifier son tarif propre. Les prix actuels de l’API officielle DeepSeek concernent les modèles qu’elle propose aujourd’hui, pas automatiquement les poids historiques de R1.
DeepSeek R1 ou un modèle DeepSeek plus récent : lequel choisir ?
R1 conserve un intérêt pour l’étude des modèles de raisonnement et pour les utilisateurs souhaitant disposer de poids précis. Toutefois, les services DeepSeek actuels ont évolué depuis janvier 2025.
Au 26 octobre 2026, la documentation de l’API officielle propose notamment deepseek-flash, associé à DeepSeek-V4.1-Flash-1017, et deepseek-v4-pro, associé à la famille V4 Pro. Ces modèles disposent de leurs propres caractéristiques et fonctions, notamment des modes de raisonnement et des intégrations d’outils distincts de R1.
| Besoin | Option à privilégier pour l’évaluation |
|---|---|
| Comprendre les premières méthodes de raisonnement DeepSeek | R1 original et son rapport de recherche |
| Étudier les améliorations de mai 2025 | DeepSeek-R1-0528 |
| Essayer un modèle de raisonnement local de taille modérée | R1 Distill ou R1-0528-Qwen3-8B |
| Créer une nouvelle application utilisant l’API officielle | Modèles DeepSeek actuellement documentés |
| Développer un système agentique avec outils | Modèle actuel compatible avec les outils requis |
| Reproduire un résultat publié sur R1 | Poids et paramètres de la version évaluée |
Cette comparaison ne signifie pas qu’un modèle plus récent surpasse nécessairement R1 sur chaque problème. Le choix doit tenir compte de la tâche, du matériel, des fonctions nécessaires et d’évaluations réalisées dans des conditions comparables.
DeepSeek R1 est-il meilleur que ChatGPT, Gemini ou Claude ?
Lors de son lancement, DeepSeek avait publié des résultats rapprochant R1 de modèles OpenAI o1 sur des évaluations de raisonnement. La version R1-0528 a ensuite été comparée à des systèmes disponibles au printemps 2025, notamment dans les domaines mathématique et du développement logiciel.
Ces comparaisons restent historiques. Elles ne permettent pas d’affirmer que DeepSeek R1 dépasse les versions actuelles de ChatGPT, Gemini ou Claude.
Une comparaison pertinente doit préciser les variantes testées, les dates, les budgets de génération, l’usage éventuel d’outils et les métriques. Pour un utilisateur, la capacité à exécuter un modèle localement peut aussi compter davantage qu’un écart de score sur un benchmark.
Limites de DeepSeek R1 et confidentialité des données
Malgré son orientation vers le raisonnement, DeepSeek R1 présente des limites qui doivent être connues avant de l’utiliser pour des décisions importantes.
- Erreurs factuelles : le modèle peut produire des informations inexactes ou une conclusion non justifiée.
- Calculs et code : des résultats apparemment corrects peuvent échouer à une vérification indépendante ou à des tests.
- Temps de génération : les tâches complexes peuvent consommer davantage de jetons et augmenter la latence.
- Connaissances récentes : un modèle non connecté à une source actualisée ne garantit pas des informations récentes.
- Multimodalité : les versions originales R1 documentées comme modèles texte ne doivent pas être confondues avec les modèles multimodaux plus récents.
- Compatibilité : les fonctions d’appel d’outils et les limites dépendent de la version et du moteur d’inférence.
- Déploiement : le modèle complet demande des ressources importantes, même lorsqu’il utilise une architecture MoE.
Les données envoyées à DeepSeek sont-elles confidentielles ?
La réponse dépend de la méthode d’accès.
La politique de confidentialité DeepSeek mise à jour le 10 février 2026 indique que les services concernés peuvent collecter les entrées, fichiers et contenus fournis par les utilisateurs. Elle précise que les données personnelles traitées dans ces services peuvent être conservées et traitées en République populaire de Chine.
Cette politique distingue également les services officiels des applications créées par des développeurs tiers. Un fournisseur hébergeant lui-même les poids R1 peut appliquer d’autres conditions de traitement des données.
Une installation locale correctement configurée peut permettre de traiter les entrées sans les envoyer à un serveur d’inférence distant. Toutefois, la confidentialité dépend aussi des autres composants : interfaces, plugins, télémétrie, services de recherche et éventuelles connexions réseau.
Pour des données personnelles ou professionnelles sensibles, examinez les politiques applicables, les flux de données et les obligations pertinentes avant d’utiliser un service hébergé. La disponibilité de poids téléchargeables ne constitue pas à elle seule une garantie de sécurité ou de conformité au RGPD.
Questions fréquentes sur DeepSeek R1
DeepSeek R1 peut-il répondre en français ?
Oui. R1 et plusieurs de ses variantes peuvent comprendre et générer des réponses en français. La qualité peut varier selon le modèle et la tâche. Pour un contenu technique ou destiné à publication, vérifiez la terminologie et les informations factuelles.
DeepSeek R1 fonctionne-t-il sans connexion Internet ?
Un modèle R1 téléchargé et exécuté avec un moteur local peut fonctionner sans connexion à une API externe, si les composants nécessaires sont déjà installés. Cela ne garantit pas que tous les logiciels et plugins associés soient totalement hors ligne.
DeepSeek R1 peut-il être utilisé pour programmer ?
Oui. DeepSeek R1 a été entraîné et évalué notamment sur des problèmes de programmation et de raisonnement algorithmique. Il peut proposer des fonctions, expliquer du code et analyser des problèmes, mais les résultats doivent être relus et testés. Pour un nouveau projet, il est utile de comparer également les modèles DeepSeek plus récents.
Le modèle DeepSeek R1 8B est-il le même que le 671B ?
Non. La version 8B actuellement utilisée par défaut dans Ollama est un modèle distillé issu de R1-0528 et fondé sur Qwen3. Le modèle complet contient 671 milliards de paramètres et possède une architecture et des besoins matériels très différents.
DeepSeek R1-0528 est-il plus récent que DeepSeek V4 ?
Non. DeepSeek-R1-0528 date de mai 2025, tandis que la famille DeepSeek V4 est apparue en 2026. Les deux appartiennent à des générations différentes. La date de sortie ne suffit toutefois pas à établir quel modèle est le meilleur pour chaque utilisation.
Faut-il encore choisir DeepSeek R1 en 2026 ?
DeepSeek R1 reste un modèle important pour la recherche sur le raisonnement, les expérimentations locales et la reproduction de résultats techniques publiés en 2025. Ses différentes versions permettent également d’étudier les compromis entre taille, ressources nécessaires et capacités de raisonnement.
Pour essayer R1 sur un ordinateur personnel, une distribution distillée identifiable, comme DeepSeek-R1-0528-Qwen3-8B, constitue un point de départ plus accessible que le modèle complet. Pour reproduire un résultat historique, utilisez exactement les poids et paramètres de la version d’origine.
Si votre objectif est plutôt de créer une nouvelle application connectée à l’API officielle DeepSeek, examinez les modèles actuellement proposés et leurs capacités documentées. Le choix le plus pertinent dépend de la version exacte, du mode d’hébergement, du matériel, du coût et du niveau de fiabilité attendu, plutôt que du seul nom DeepSeek R1.